チュートリアル: ロジスティック回帰による成功数/試行数データの分析
このチュートリアルでは、条件ごとに成功数と試行数で集計されたデータから、条件と成功確率の関係を推定します。使う手法は Grouped Binomial GLM(ロジスティック回帰)です。例として、殺虫剤の濃度を段階的に変えて昆虫に投与し、濃度ごとの死亡数を記録した用量反応データを使います。
「N 回試行して K 回成功した」という構造のデータであれば、分野を問わず同じ手順が使えます。品質検査であれば検査数のうちの合格数、疫学調査であれば対象者数のうちの発症数が同じ構造です。
このチュートリアルは、基本的な使い方 で説明する基本操作を前提とします。
データを読み込む
ランチャー画面の Sample Data セクションから Dose Response をクリックすると、8 行 4 列のデータが読み込まれます。ランチャーを経由せず、URL から直接開く こともできます。
このデータは、殺虫剤の用量反応実験を模して MIDAS プロジェクトが作成した合成データです。実在の実験記録ではありません。
ライセンスは CC0 1.0 です。MIDAS プロジェクトは著作権を行使しないため、出典表示なしで自由に利用できます。
| 列名 | 内容 |
|---|---|
dose | 殺虫剤の濃度(mg/L)です |
exposed | その濃度で曝露した昆虫の数です |
dead | そのうち死亡した昆虫の数です |
mortality_rate | 死亡率です |
分析で応答として使うのは dead と exposed の組です。mortality_rate は dead / exposed を小数第 3 位まで丸めた参考列で、モデルには入れません。
データの構造を確認する
このデータは、1 行が 1 個体ではなく 1 つの濃度条件を表します。濃度を 1.0 から 128.0 mg/L まで 2 倍刻みの 8 段階に設定し、濃度ごとに別々の 46〜52 匹へ殺虫剤を投与して、死亡数を数えた実験を模しています。
8 行しかないので、全データを示します。
| dose | exposed | dead | mortality_rate |
|---|---|---|---|
| 1.0 | 50 | 1 | 0.020 |
| 2.0 | 48 | 3 | 0.063 |
| 4.0 | 46 | 8 | 0.174 |
| 8.0 | 50 | 28 | 0.560 |
| 16.0 | 47 | 42 | 0.894 |
| 32.0 | 52 | 49 | 0.942 |
| 64.0 | 49 | 47 | 0.959 |
| 128.0 | 51 | 50 | 0.980 |
Grouped 形式と Binary 形式
成功数と試行数を 1 行に集計したこの形式を、Binomial GLM では Grouped と呼び、個体ごとに 1 行を使う Binary と区別します。Binary は 1 個体ごとに死亡 = 1、生存 = 0 を記録する形式で、濃度 1.0 mg/L の 50 匹は 50 行になります。Grouped は同じ 50 匹の記録を、死亡数 dead = 1、曝露数 exposed = 50 の 1 行で表します。
個体ごとに値が異なる説明変数がなければ、係数と標準誤差の推定はどちらの形式でも一致します1。このデータの説明変数は濃度だけで、同じ濃度の個体はすべて同じ値を持つため、集計しても推定に必要な情報は失われていません。体重のような個体レベルの説明変数を使いたい場合は、個体ごとに記録した Binary 形式のデータが必要です。
Grouped 形式の 1 行を二項分布として扱えるのは、行内の個体が互いに独立で、同じ死亡確率を持つとみなせるときです。同じ容器で育てた群のように個体にまとまりがあると、実際のばらつきは二項分布の想定より大きくなります。このずれを過分散と呼び、診断の節 で兆候の有無を確かめます。
データのパターンを見る
用量反応実験で想定される、死亡率が濃度の対数に対して S 字型を描くという関係を、散布図で確かめます。Analysis > Graph Builder... で Custom Graph を選び、X に dose、Y に mortality_rate を割り当て、Scales セクションで X のスケールを log にします。低濃度で死亡率はほぼ 0 に、高濃度でほぼ 1 に近づき、その間で単調に増えています。
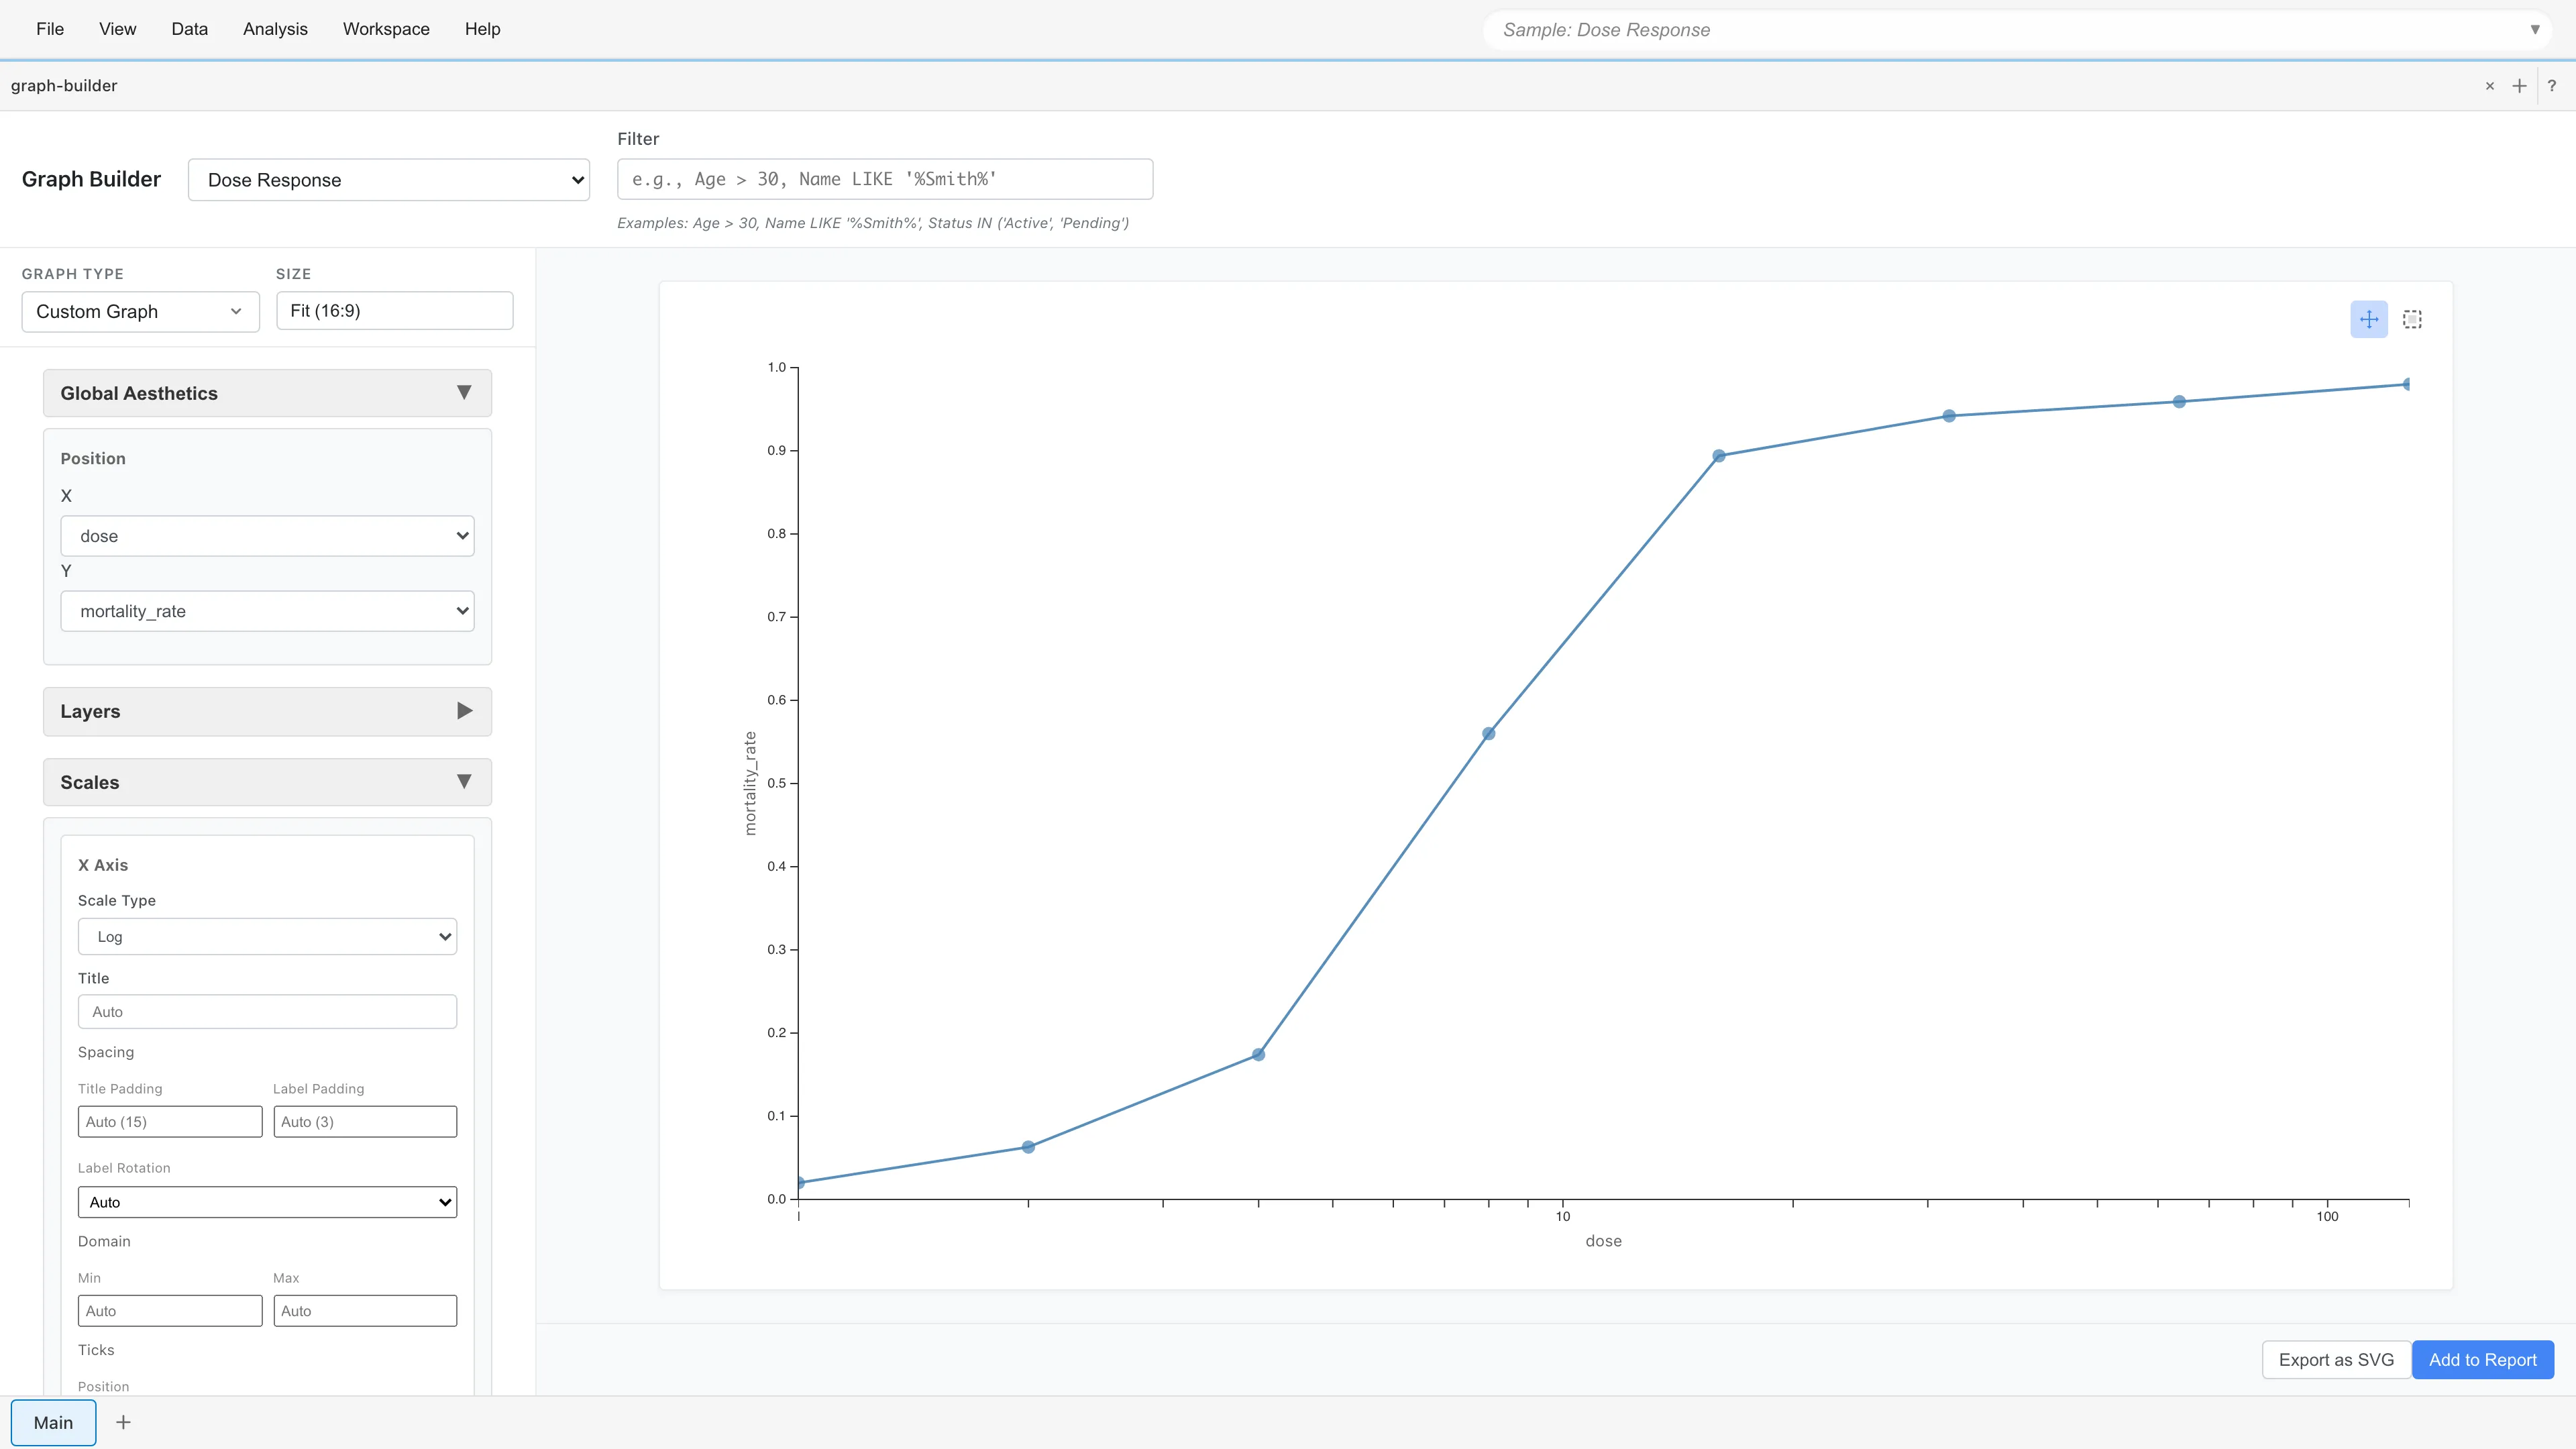
ロジスティック回帰は、この S 字型を対数オッズと説明変数の線形関係としてモデル化します。死亡確率 のオッズは で、対数オッズはその対数 です。確率は 0 から 1 の範囲に限られますが、対数オッズは から の値を取るため、線形式 でそのまま表せます。この対応づけを Logit リンクと呼びます。リンク関数を含む GLM の数理は GLM の基礎 を参照してください。
説明変数を対数変換する
散布図の形に合わせて、dose の対数を説明変数にします。S 字が見えたのは横軸を対数にしたときなので、対数オッズと線形の関係を仮定できる候補は dose そのものではなく log(dose) です。dose をそのまま使うとどうなるかは、モデルの指定を誤るとどうなるか で確かめます。
Data > Add Columns... を開き、log_dose 列を追加した派生データセットを作ります。Column name に log_dose、SQL expression に LN("dose") を入力します。Preview で結果を確認し、Output Name にデータセット名を入力して Save as Dataset をクリックします。
GLM を設定して実行する
Analysis > Generalized Linear Model (GLM)... を開き、データセット・分布族・応答の形式と列を設定します。
- Dataset で、Add Columns で保存した派生データセットを選びます
- Distribution Family で Binomial (Logistic) を選びます
- Response format で Grouped (n trials) を選びます
- Successes に
dead、Trials にexposedを指定します
この指定を受けて、MIDAS は応答を死亡率(dead / exposed)に変換し、exposed を重みとして推定します。
続けて説明変数・リンク関数・切片を設定します。Predictor Variables (X) で log_dose にチェックを入れます。Link Function は既定の Logit のまま、Include intercept はオンのままにします。
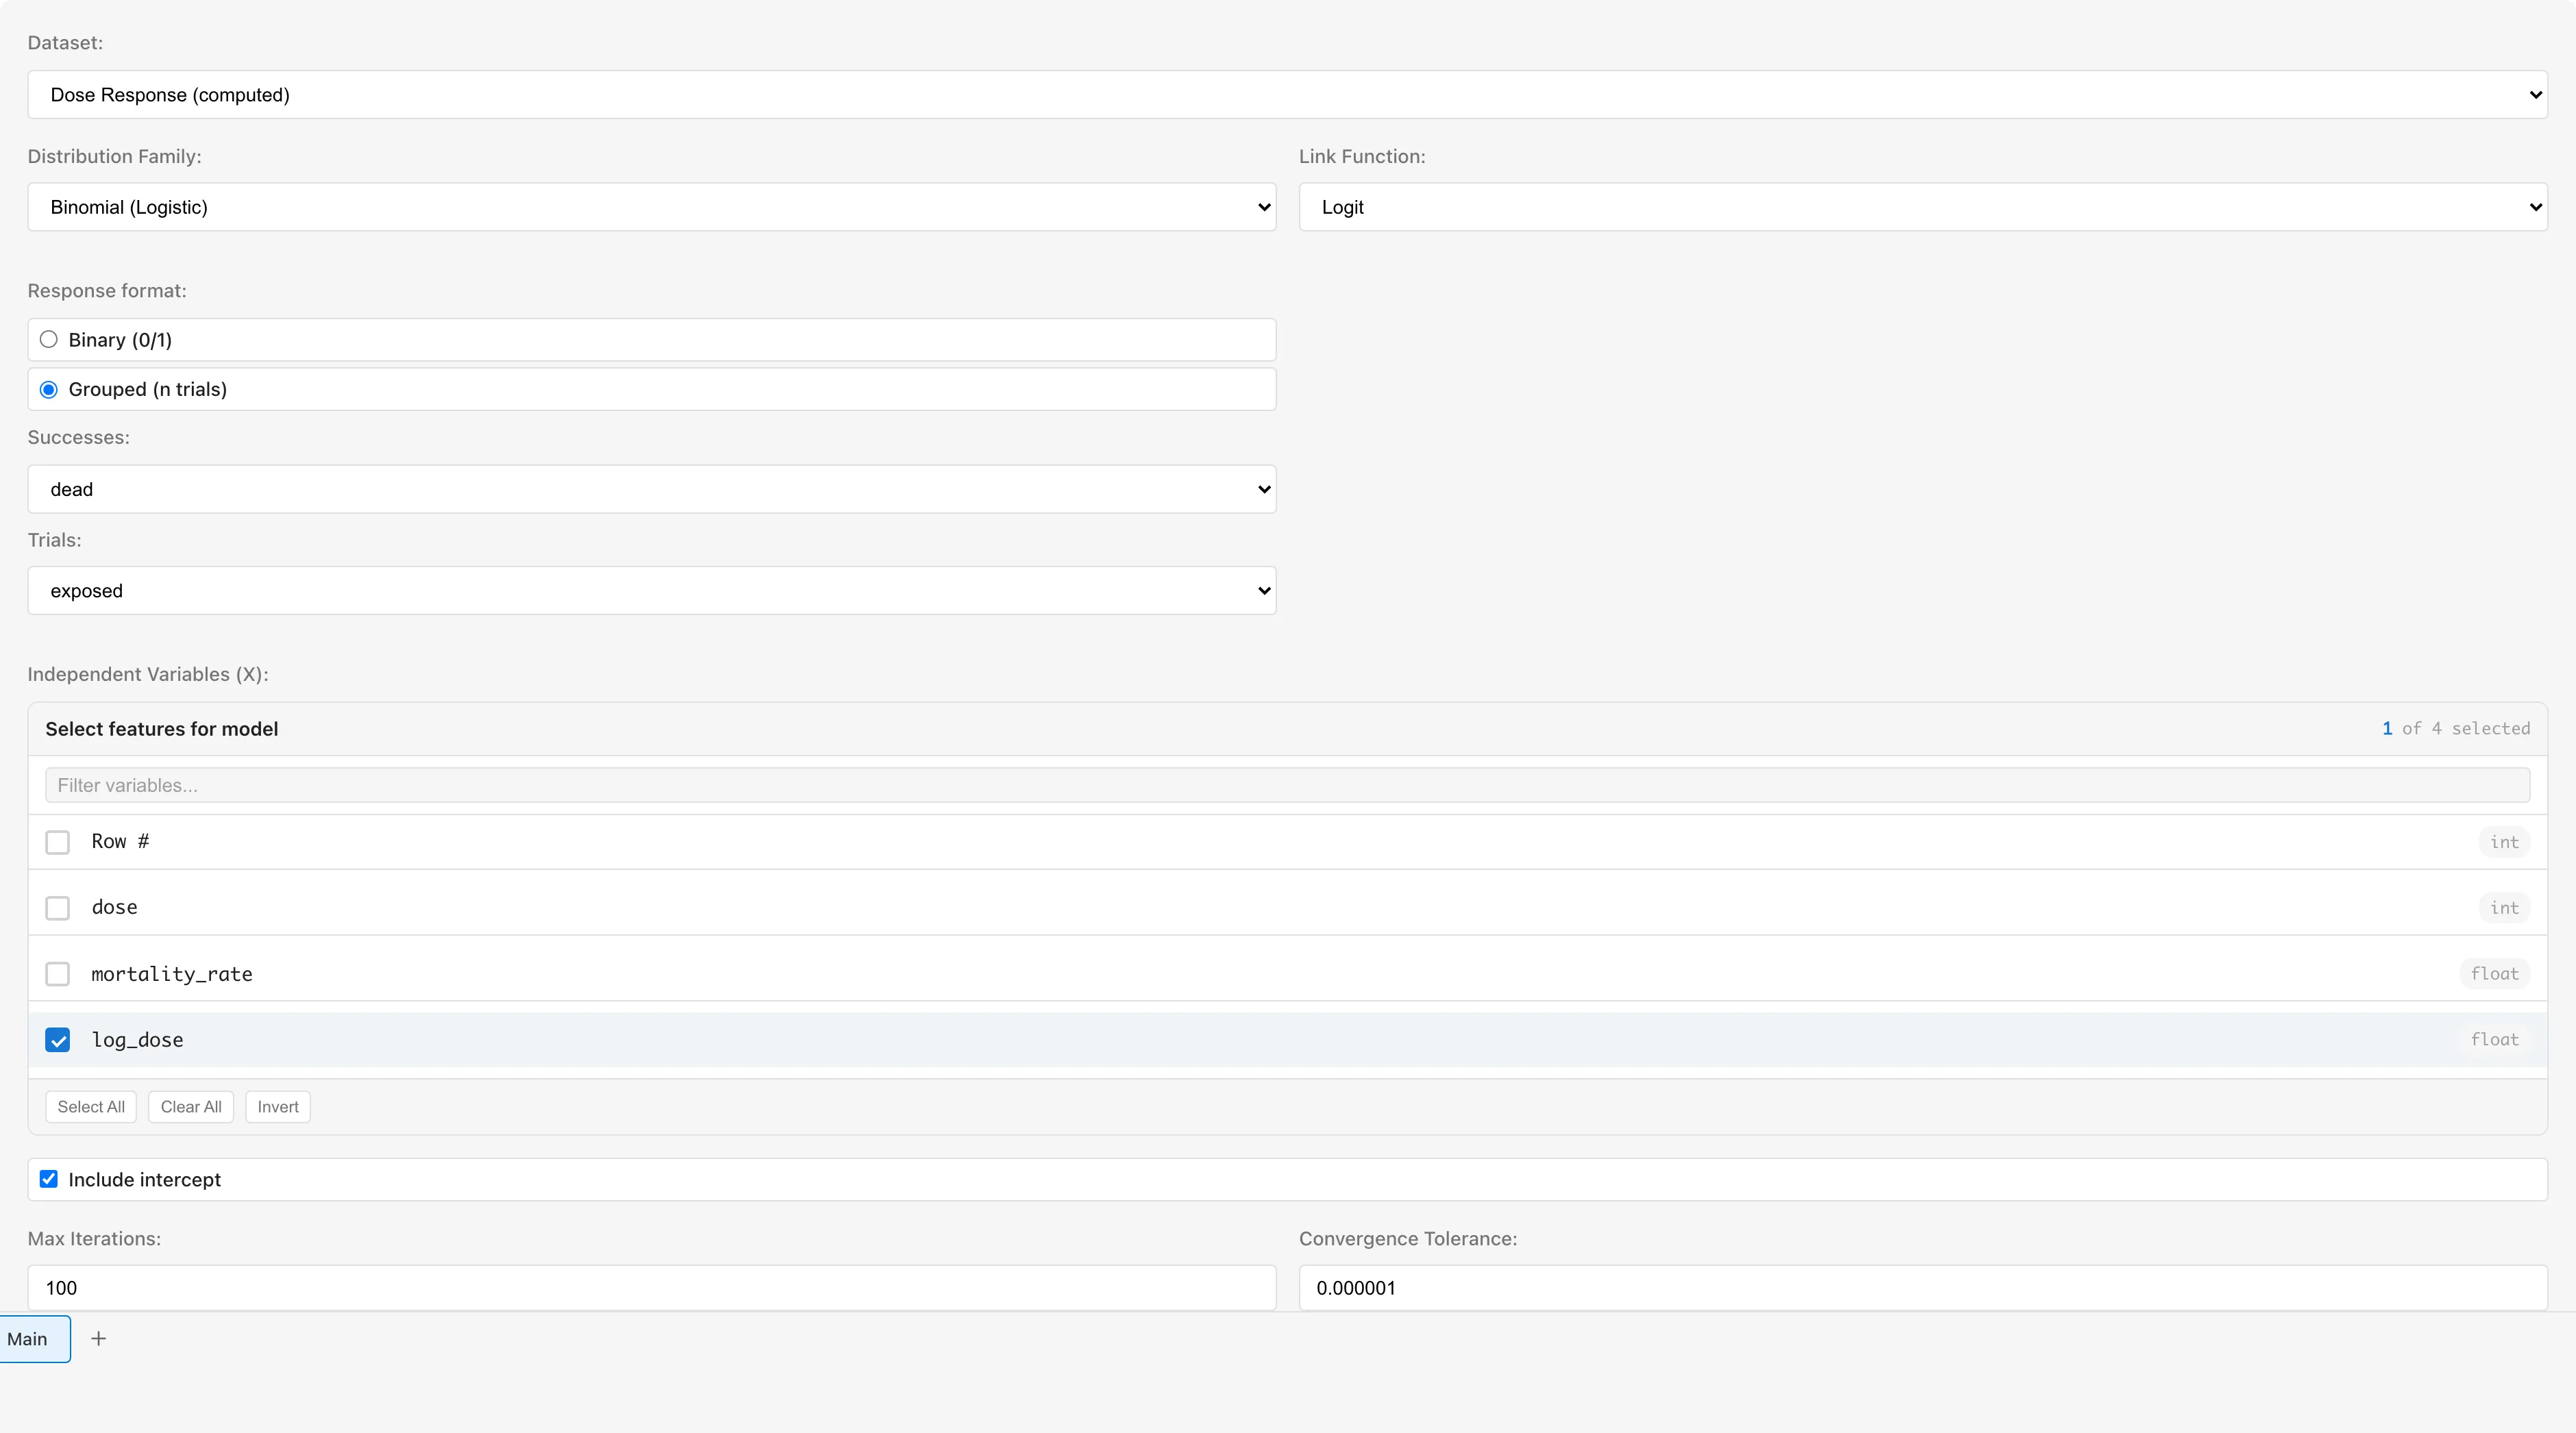
Run GLM をクリックすると推定が始まり、収束すると結果が表示されます。反復ごとの Deviance の値は、結果末尾の Convergence History で確認できます。
結果を読む
結果エリア上部の Convergence・Residual Deviance・AIC で推定の状態を確認します。Convergence が Converged (5 iterations) と表示され、推定は収束しています。Residual Deviance と AIC の読み方は GLM タブ を参照してください。
適合度の下には Prediction Accuracy Metrics として Brier Score・AUC と ROC 曲線が表示されます。これらは当てはめに使ったデータ自身で計算した指標で、成功数と試行数の形式では試行数で重み付けされます。読み方は GLM タブ: 当てはめデータでの予測精度指標 を参照してください。
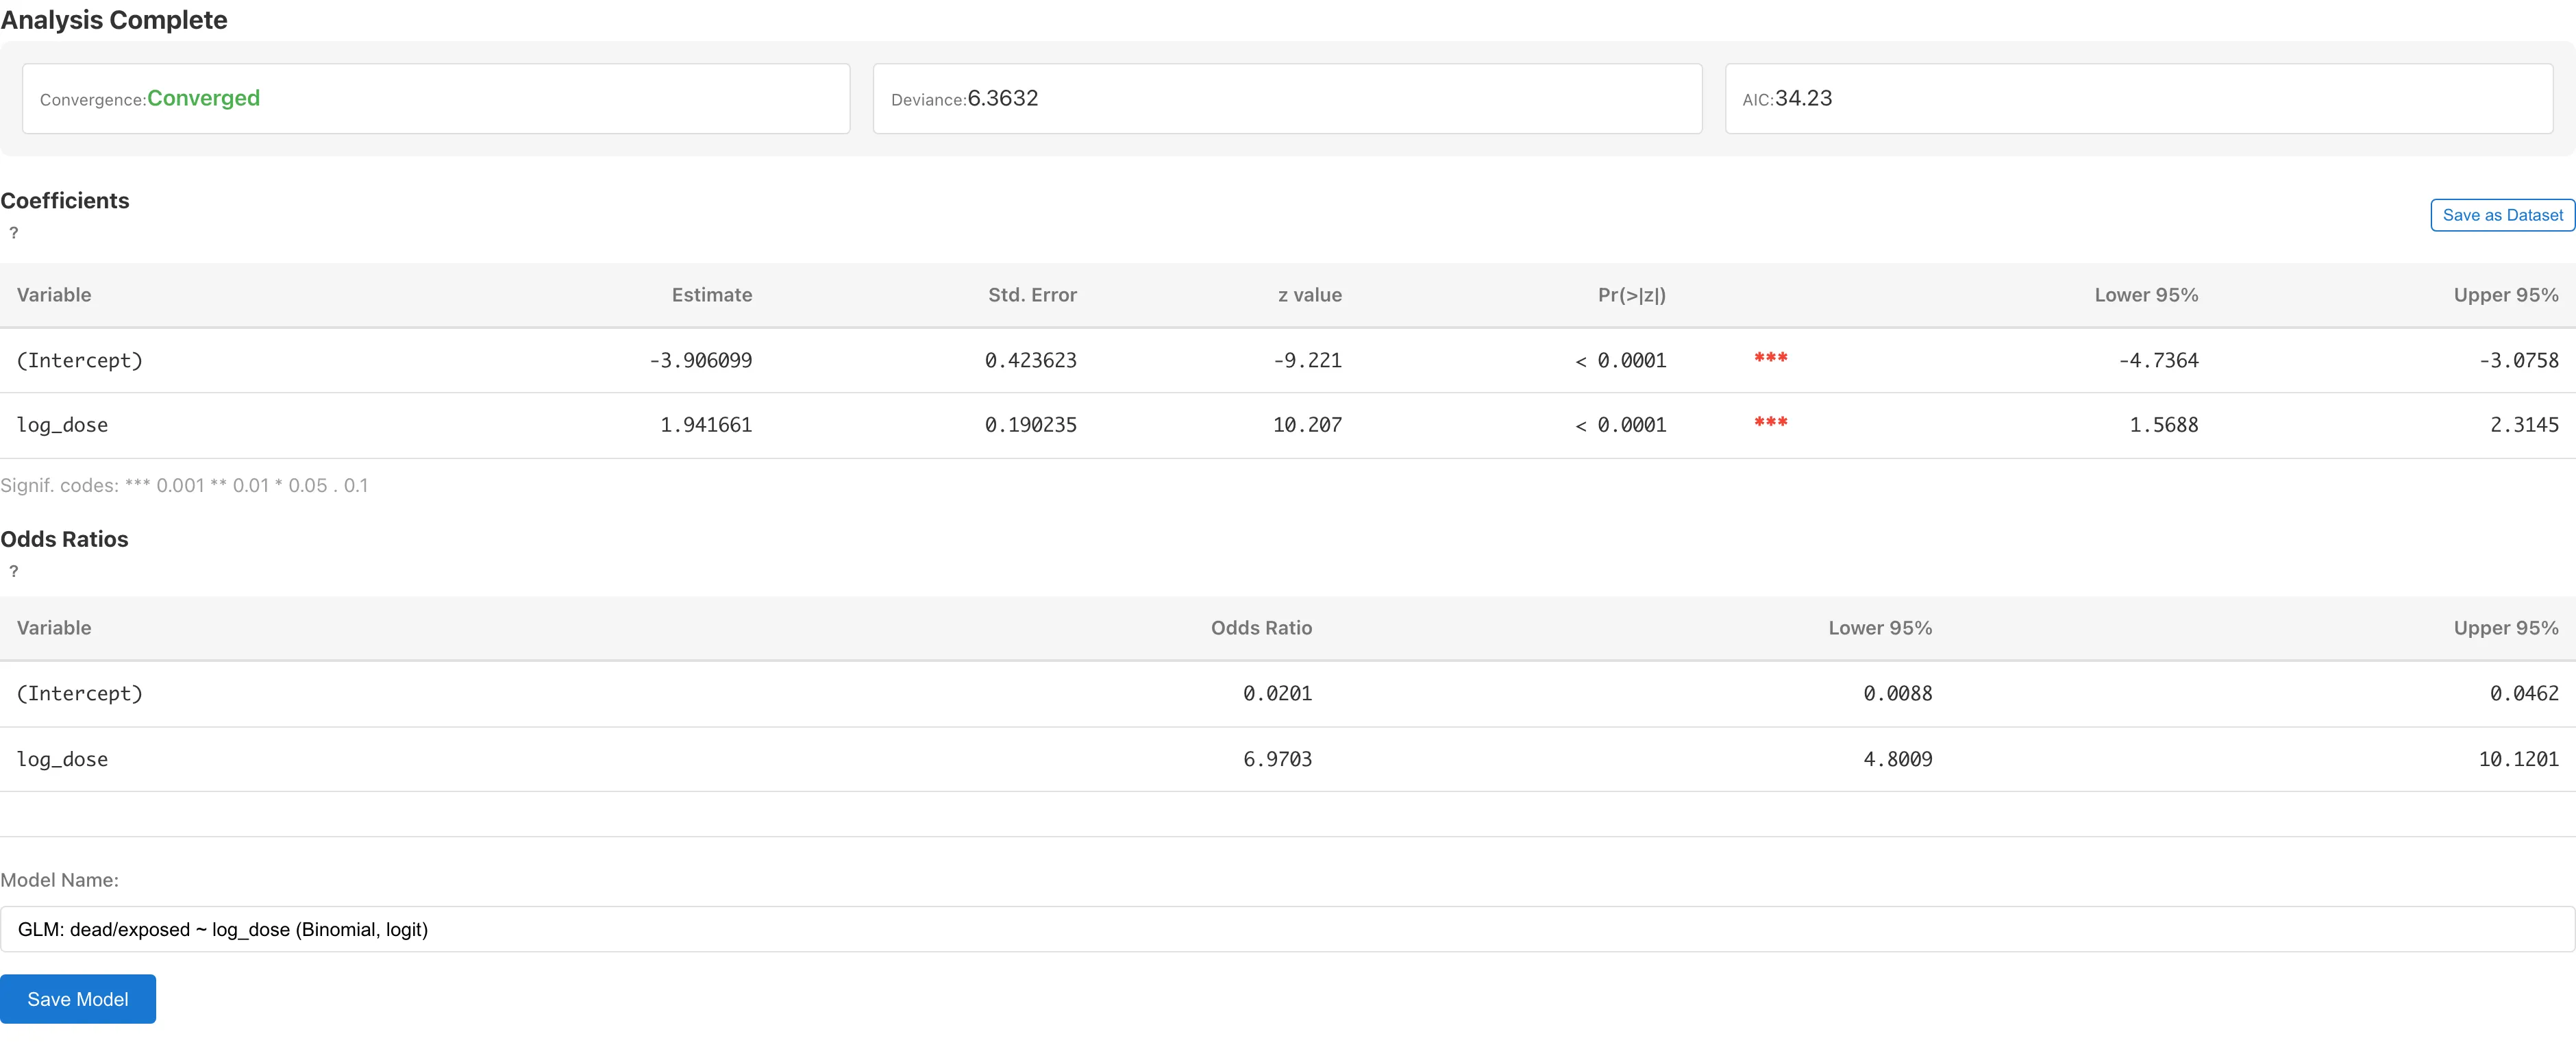
係数テーブルの log_dose の行が、濃度と死亡確率の関係の推定です。係数は対数オッズスケールの傾きです。log_dose が 1 増えたとき、すなわち dose が 倍になったときの対数オッズの変化量を表します。推定値は 1.94 で正なので、濃度が高いほど死亡確率が高いと推定されます。
| Estimate | Std. Error | Lower 95% | Upper 95% | OR | exp(Lower 95%) | exp(Upper 95%) | |
|---|---|---|---|---|---|---|---|
| (Intercept) | -3.906099 | 0.423623 | -4.736386 | -3.075813 | 0.0201 | 0.0088 | 0.0462 |
| log_dose | 1.941661 | 0.190235 | 1.568807 | 2.314515 | 6.9703 | 4.8009 | 10.1200 |
OR 列を使うと、係数をオッズ比として読めます。OR は Estimate を指数変換した の値で、exp(Lower 95%) と exp(Upper 95%) は 95% 信頼区間を同じ変換で写した値です。log_dose の OR は 6.97 で、95% 信頼区間は 4.80 から 10.12 です。dose が 倍になると、死亡のオッズは約 7 倍になると推定されます2。
このデータのように濃度が 2 倍ずつ増える設計では、2 倍あたりに換算すると読みやすくなります。 なので、濃度が 2 倍になるごとに死亡のオッズは約 3.8 倍になると推定されます。
モデルを保存して診断プロットを確認する
Model Name にモデル名を入力して Save Model をクリックすると、View Diagnostics ボタンが現れます。View Diagnostics をクリックすると、診断プロットを表示する GLM Diagnostics タブが開きます。
Binomial の診断で確認に使うのは、3 つの診断プロットと Deviance/df 比です。GLM Diagnostics タブには 4 つのプロット枠がありますが、Gaussian 以外の分布族では Normal Q-Q プロットは表示されず、その枠には説明文だけが表示されます。Deviance/df 比の読み方は GLM タブ を参照してください。
Residuals vs Fitted では、残差に系統的なパターンがないことを確認します。点がゼロの水平線の周りに散らばっていれば、対数オッズと説明変数の線形関係という仮定に明らかな破れはありません。このデータは 8 点しかないため、微妙なずれまでは検出できません。
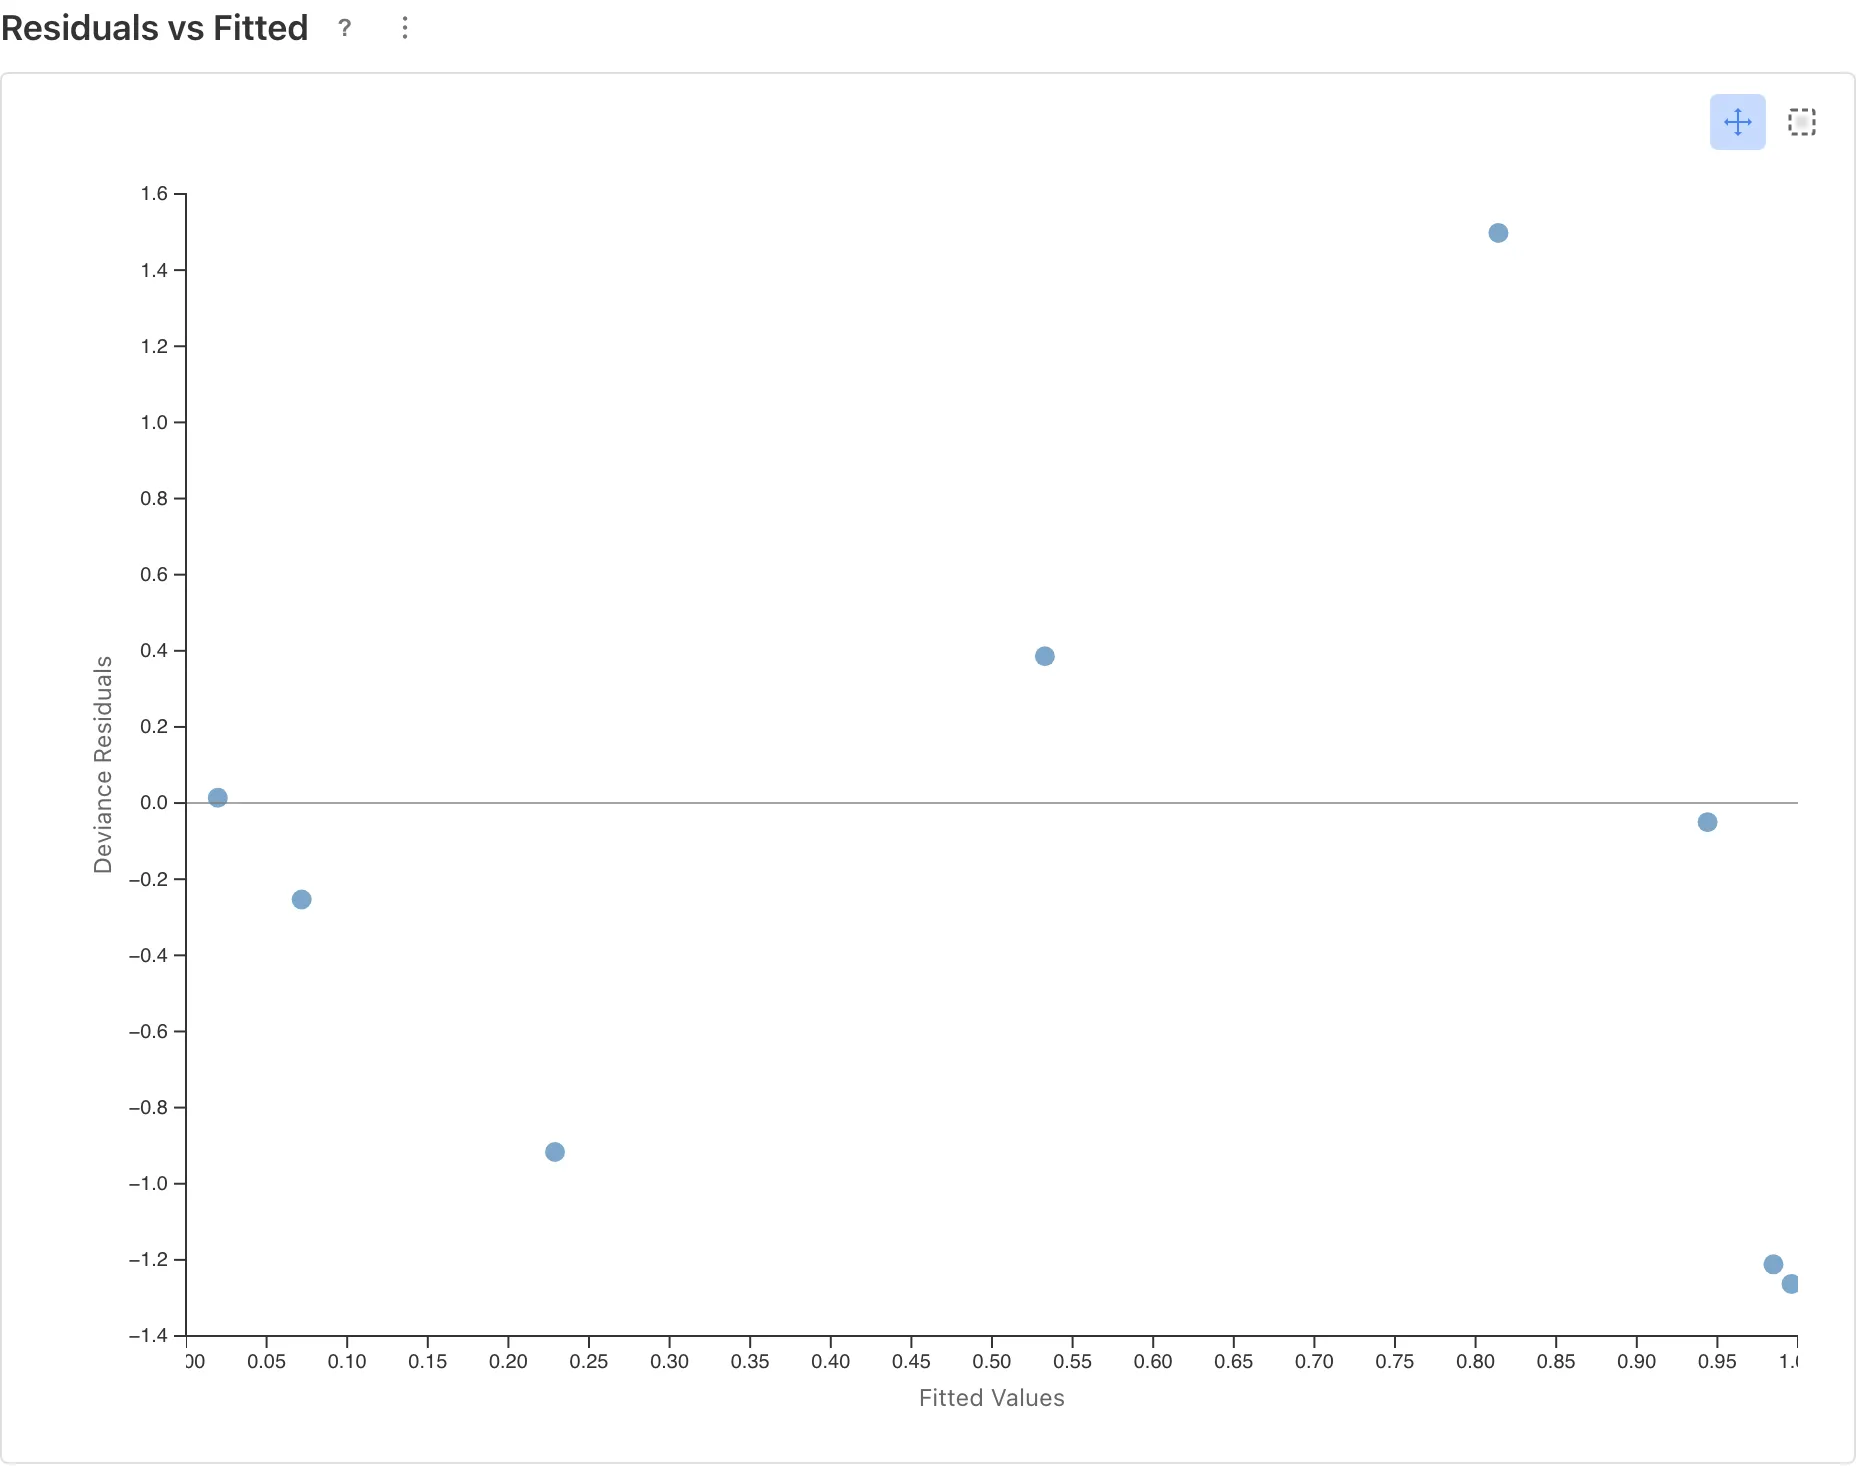
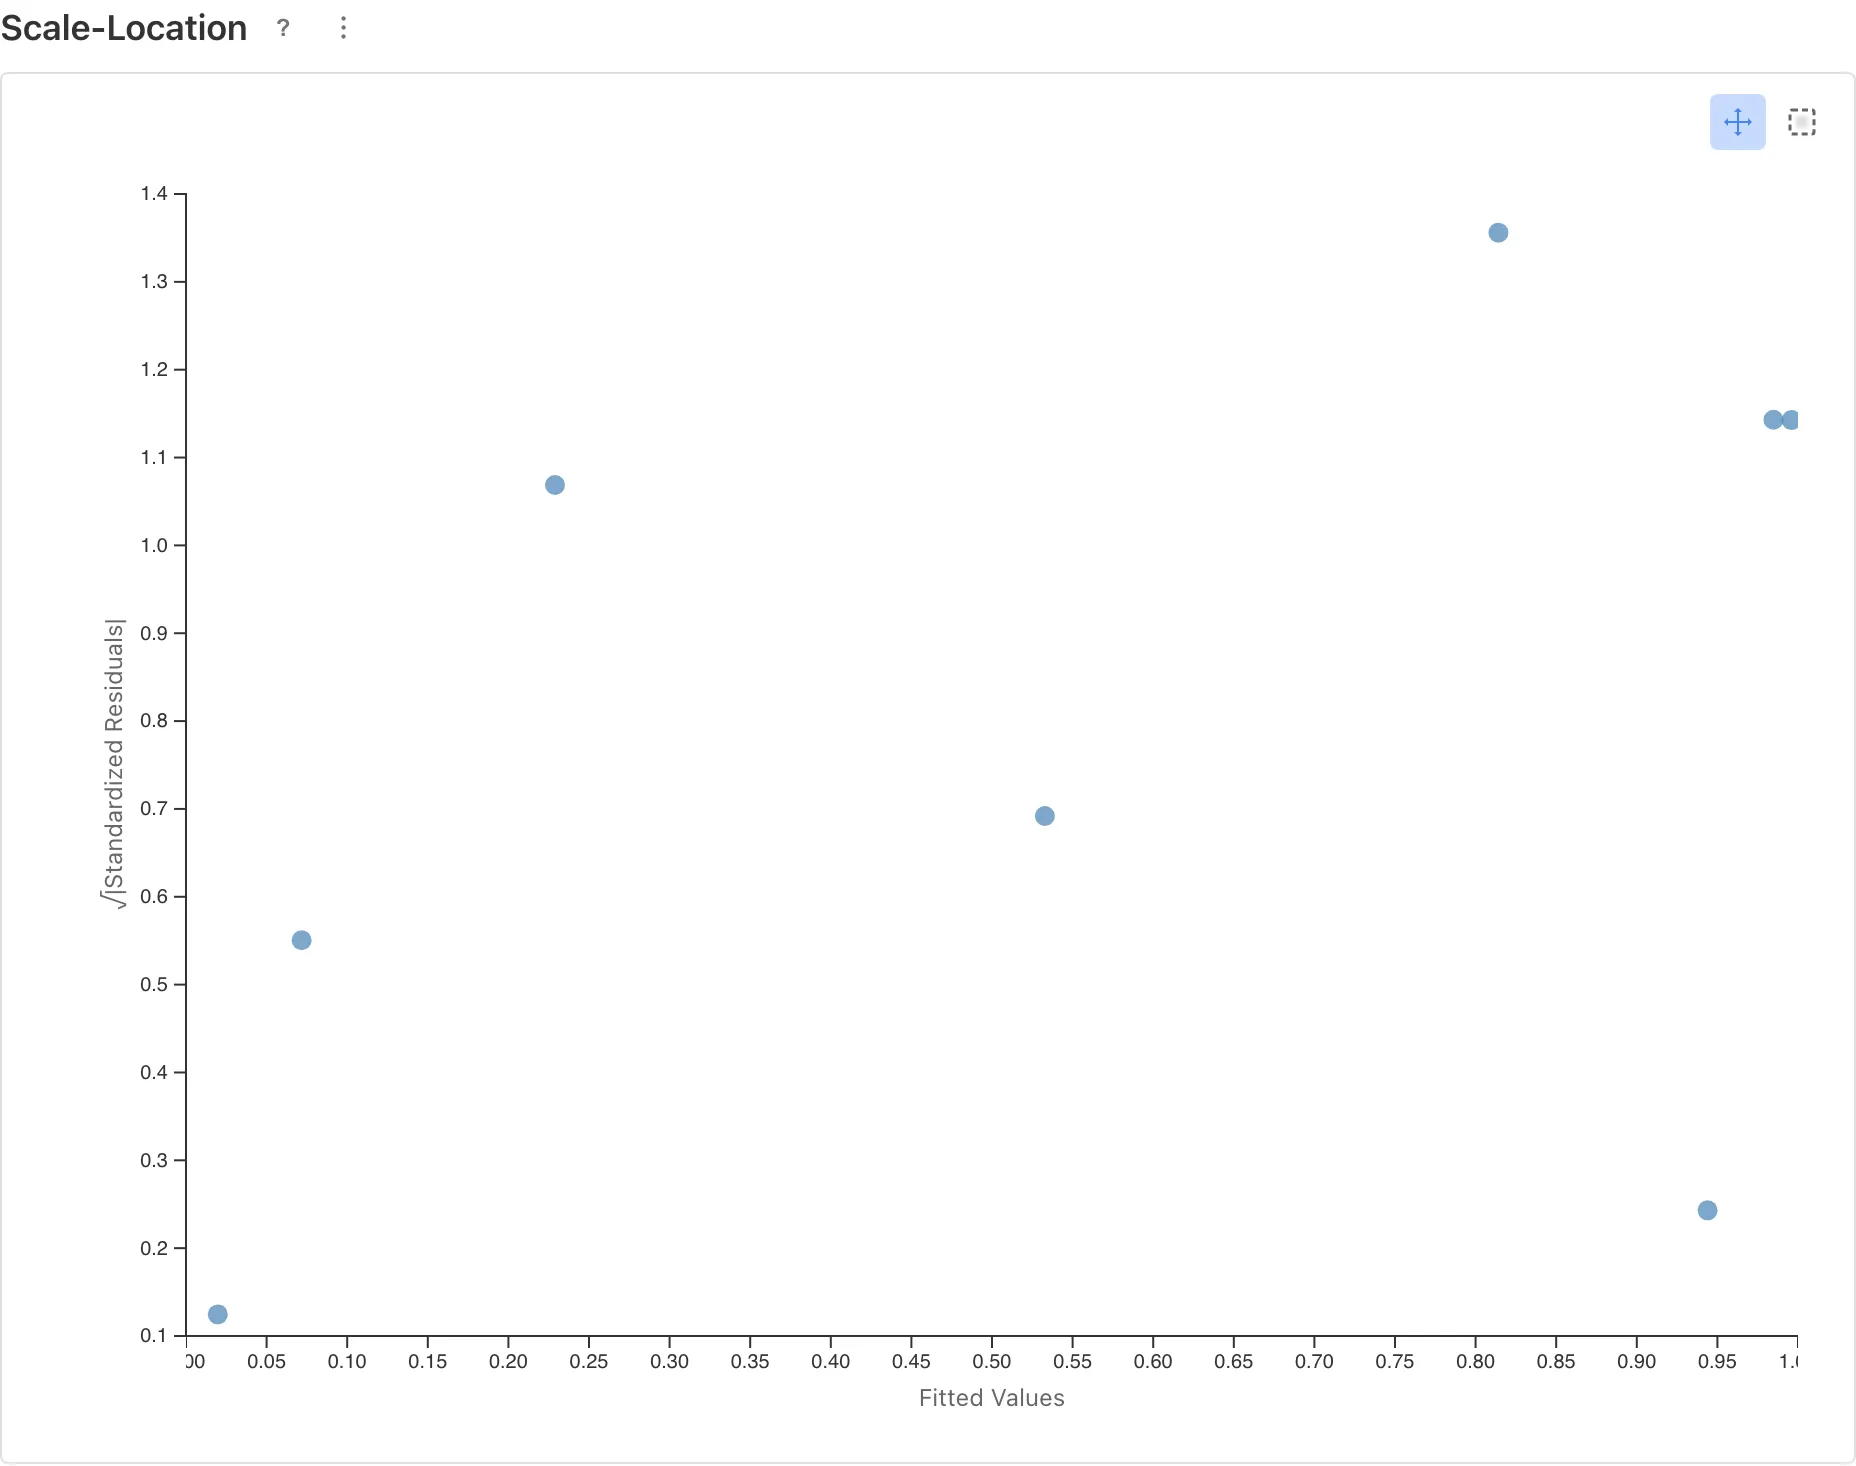
Scale-Location では、過分散の兆候がないことを確認します。残差の大きさが予測値に対して右上がりに増えていく場合は、モデルが仮定する分散よりデータのばらつきが大きい可能性があります。このプロットに明確な傾向はなく、Deviance/df 比も 6.3632 / 6 ≈ 1.06 と 1 に近いため、過分散の兆候は見られません。過分散の意味と対処は GLM の基礎: 分散関数と過分散 を参照してください。
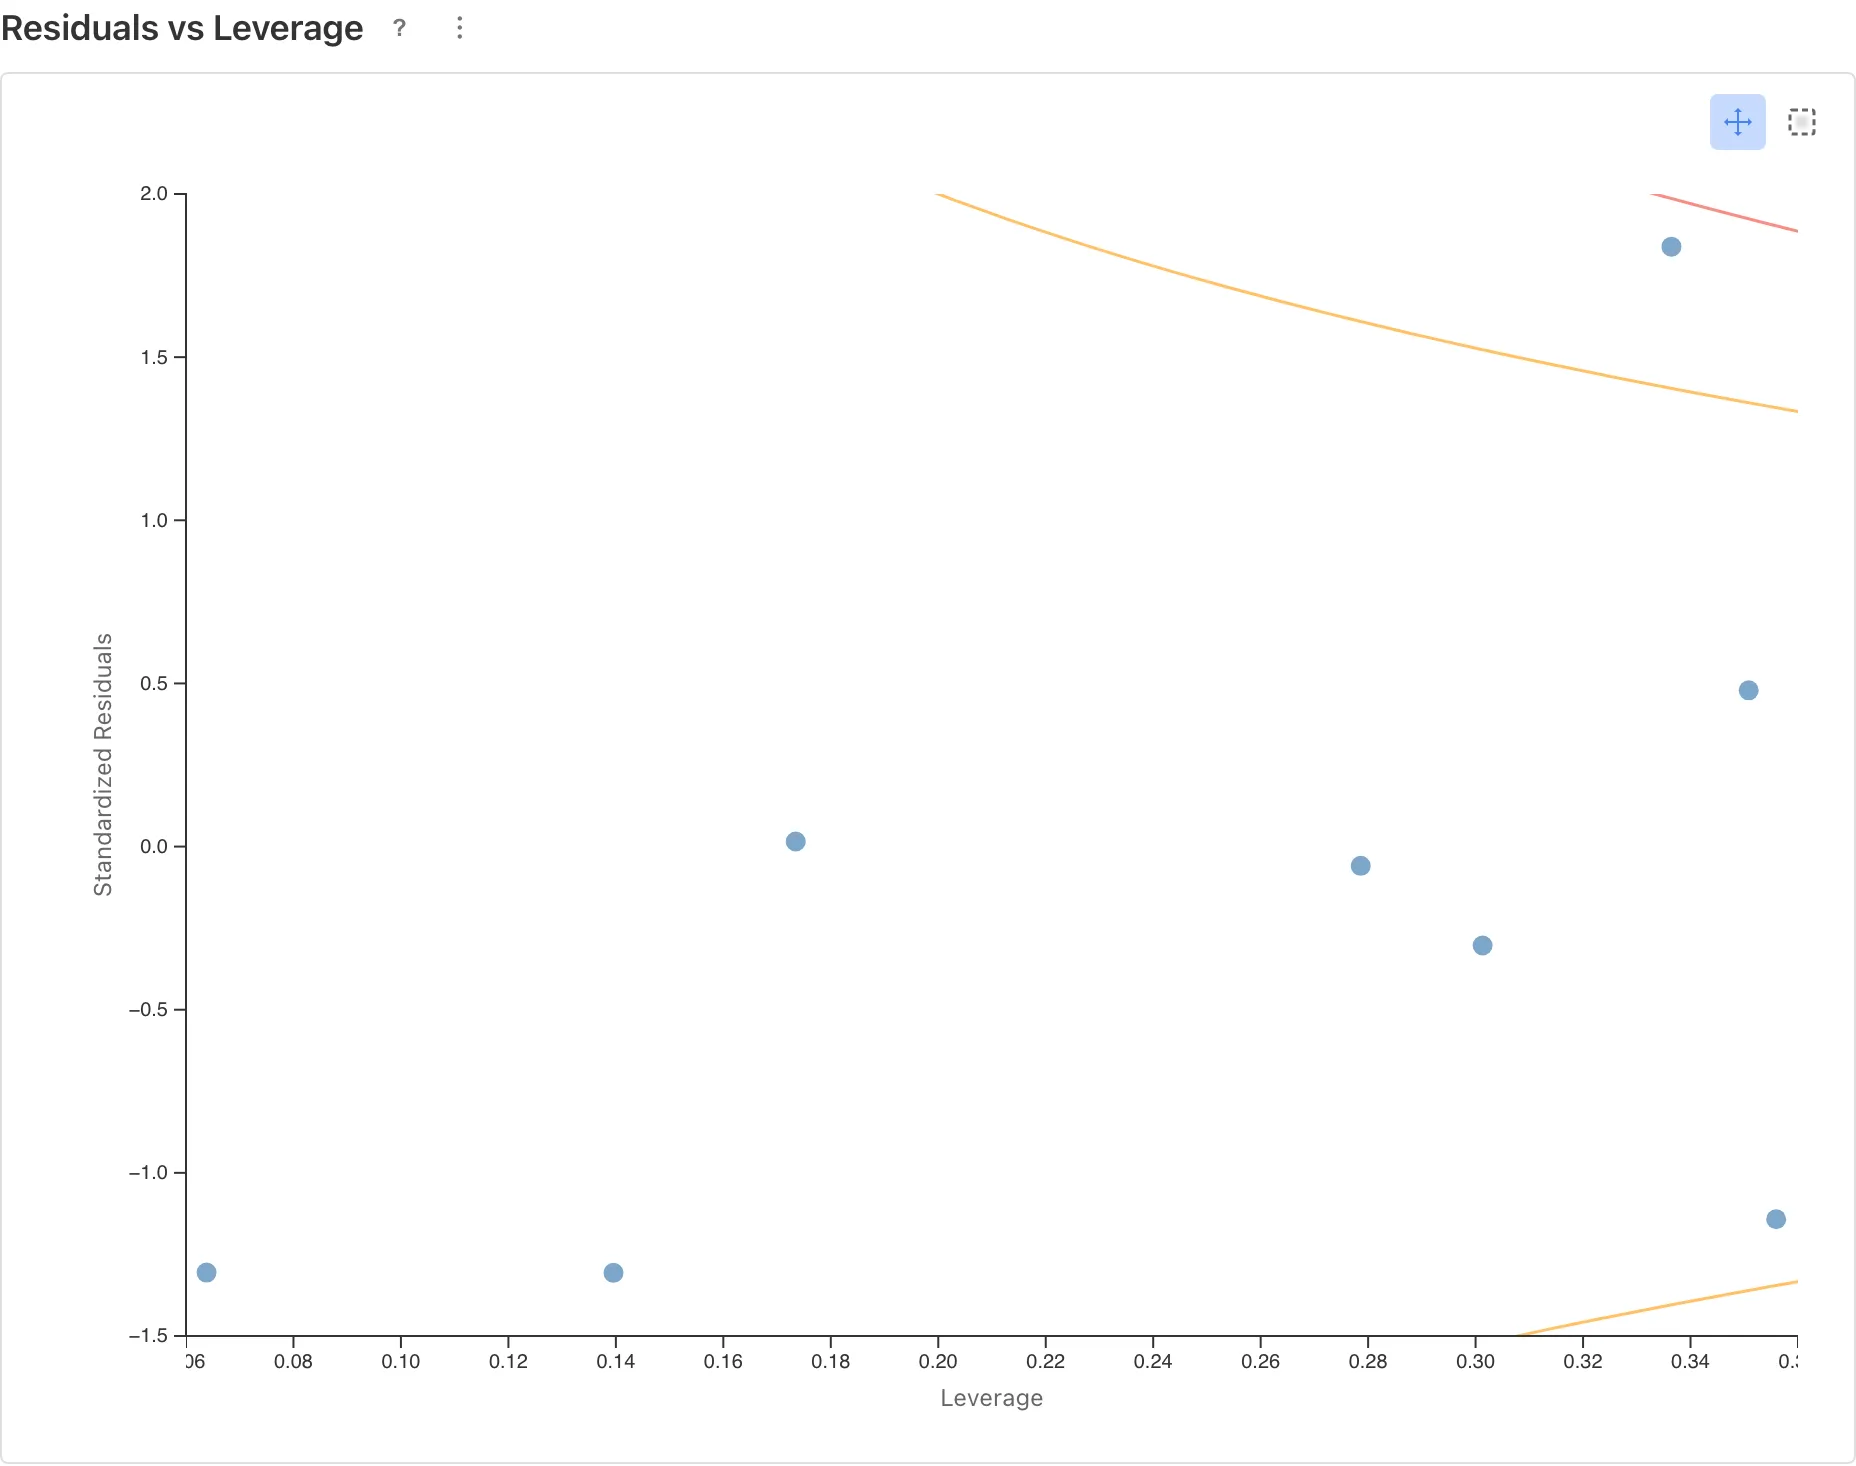
Residuals vs Leverage では、影響の大きい観測がないかを確認します。目安になるのは Cook's Distance の等高線 D = 0.5 と D = 1.0 です。等高線の外側にある点は、その 1 行を除くと推定結果が大きく変わる可能性があります。このデータでは dose = 16 の行が D = 0.5 の等高線を超えています。観測された死亡率 0.894 に対してモデルの予測は約 0.81 で、正の方向のずれが最も大きい行です。この行の Cook's Distance は他のどの行よりも大きく、推定への影響が最も大きい行であることを踏まえて結果を読みます。
モデルの指定を誤るとどうなるか
比較のため、dose を対数変換せずそのまま説明変数にして当てはめます。このモデルは対数オッズと dose の線形関係を仮定しますが、散布図で見たとおり、データの関係は log(dose) との間にあります。GLM フォームに戻り、Predictor Variables (X) で log_dose のチェックを外して dose にチェックを入れ、Run GLM をクリックします。診断プロットを見るには、このモデルにも名前を付けて Save Model で保存し、View Diagnostics を開きます。
この誤指定は、Residuals vs Fitted の逆 U 字パターンとして現れます。予測値の中央付近で残差が正に、両端で負に偏ります。残差の絶対値も大きくなり、正しい指定では 1.5 以下だった Deviance 残差 が 4 を超えます。
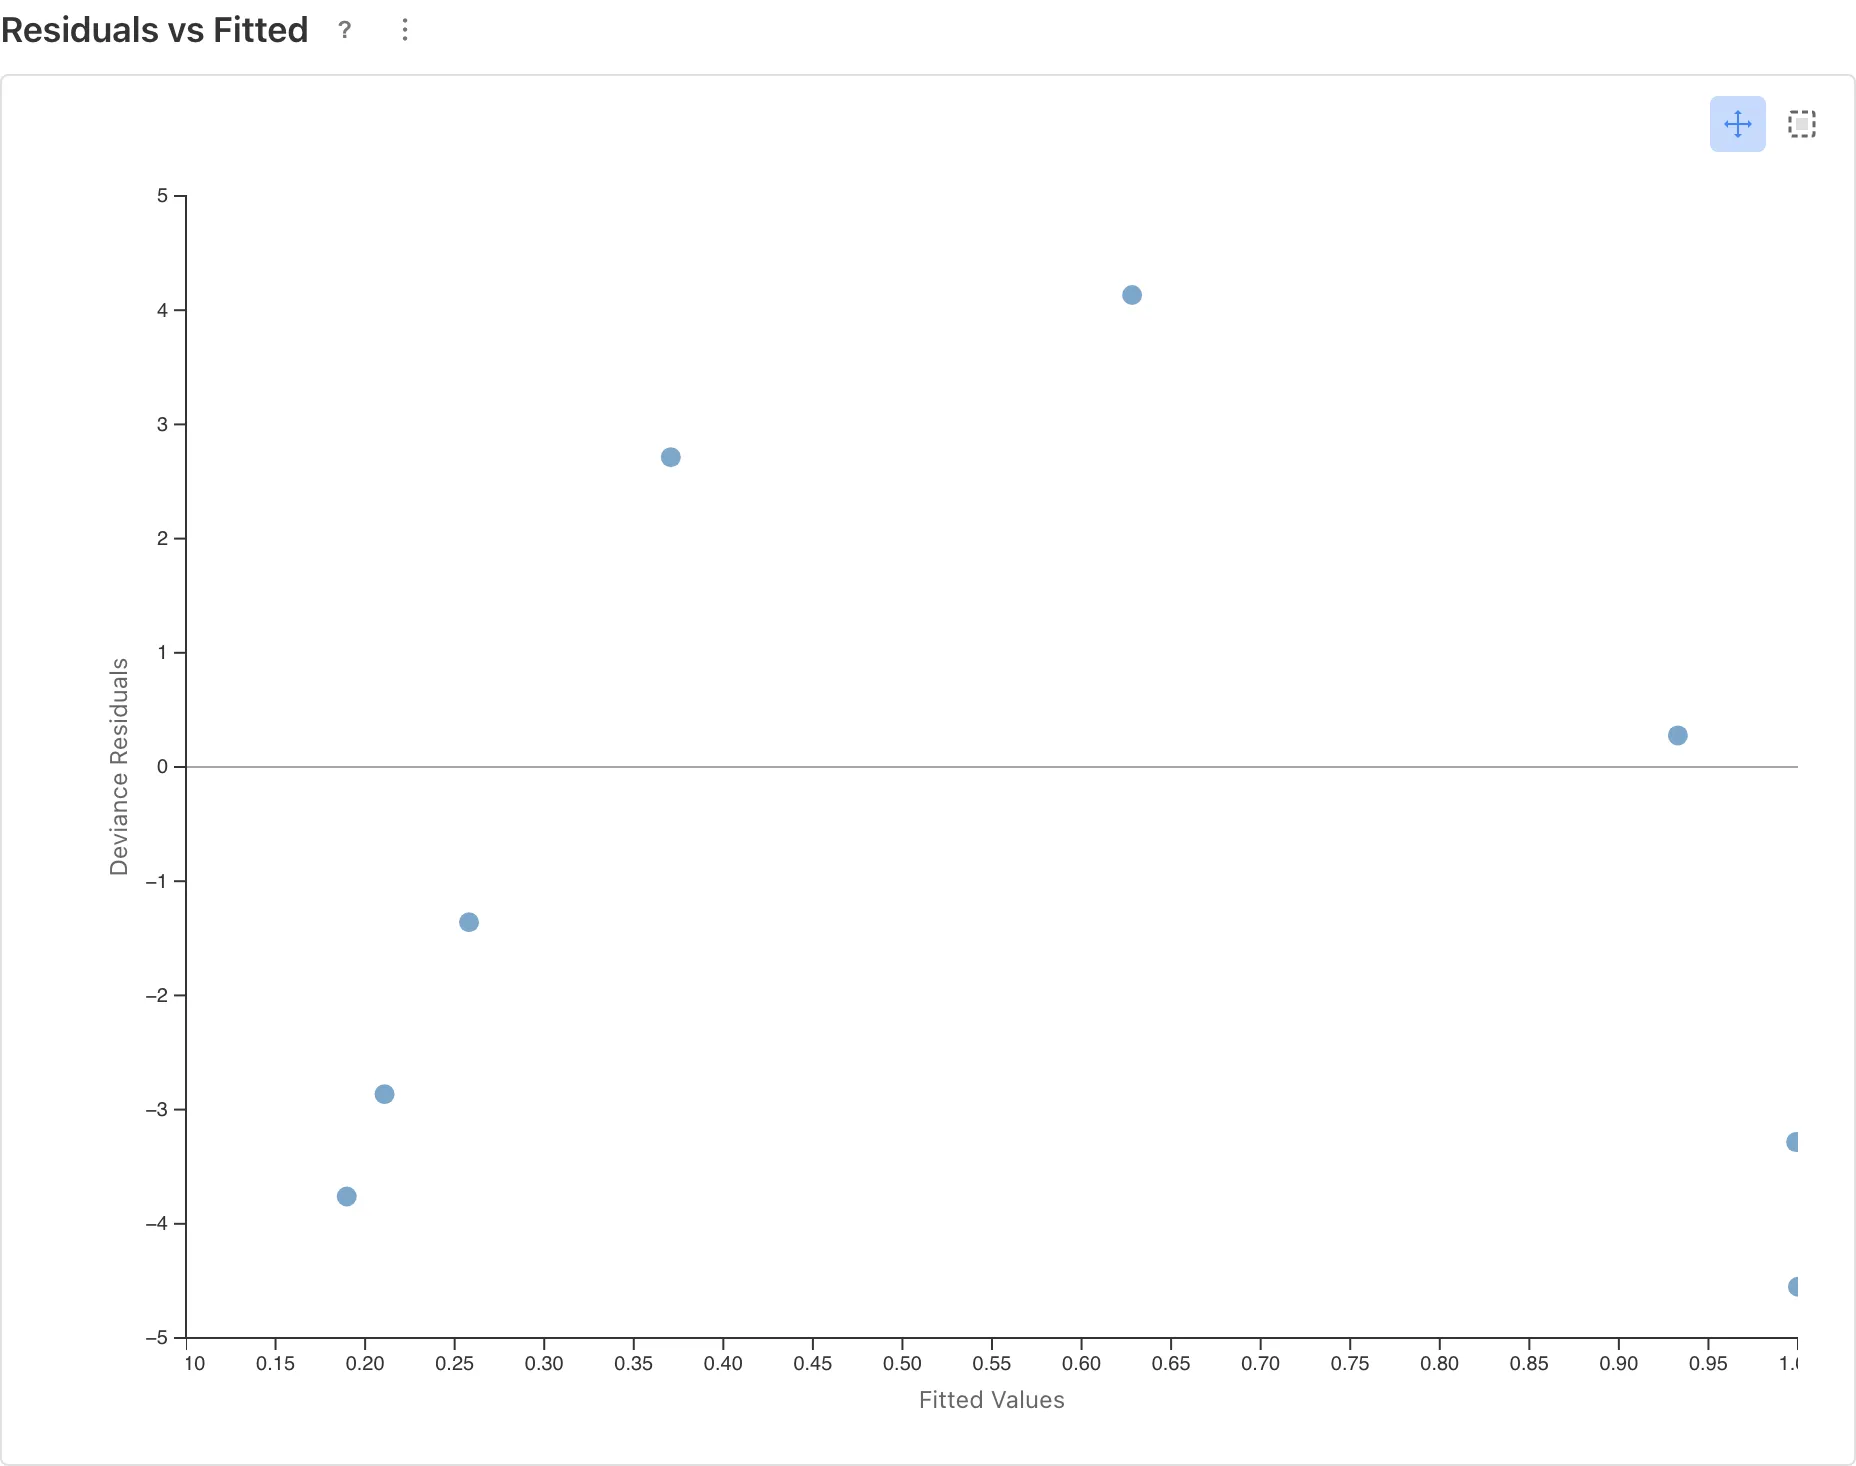
診断プロットにこの種のパターンが出たら、モデルの指定を見直します。見直しの候補は、説明変数の変換、リンク関数の変更、説明変数の追加です。
係数から派生量を計算する
死亡率がちょうど 50% になる濃度は、係数テーブルの値から計算できます。用量反応分析では、この濃度を LD50 と呼びます。死亡率 50% のとき対数オッズは 0 なので、 を LD50 について解くと次のようになります。
LD50 の区間推定には、係数の分散共分散行列と Delta 法を使います。係数テーブルの Save as Dataset をクリックすると、係数のデータセットに加えて、分散共分散行列のデータセットが「{係数データセット名} - Covariance」という名前で保存されます。SQL Query Editor で両方を参照すれば区間を計算でき、SQL の全文は 補遺 に載せています。Delta 法そのものの説明は 用語集 を参照してください。
関連ページ
- GLM タブ -- 分布族・リンク関数・予測機能の詳細
- GLM の基礎 -- リンク関数の数理、IRLS、過分散
- サンプルデータセット -- Dose Response の内容とライセンス
補遺
Delta 法による LD50 の区間推定
の分散を 1 次のテイラー展開で近似し、対数スケールで信頼区間を作ってから指数変換で元のスケールへ戻します。指数変換を経るため、元のスケールでの区間は点推定を挟んで左右非対称になります。
係数のデータセットを「GLM Coefficients」という名前で保存した場合、SQL は次のようになります。別の名前で保存した場合は、FROM 句の 2 つのテーブル名を読み替えてください。
WITH coef AS (
  SELECT
    MAX(CASE WHEN "Variable" = '(Intercept)' THEN "Estimate" END) AS b0,
    MAX(CASE WHEN "Variable" = 'log_dose' THEN "Estimate" END) AS b1
  FROM "GLM Coefficients"
),
cov AS (
  SELECT
    MAX(CASE WHEN row_var = '(Intercept)' AND col_var = '(Intercept)' THEN value END) AS v00,
    MAX(CASE WHEN row_var = '(Intercept)' AND col_var = 'log_dose' THEN value END) AS c01,
    MAX(CASE WHEN row_var = 'log_dose' AND col_var = 'log_dose' THEN value END) AS v11
  FROM "GLM Coefficients - Covariance"
)
SELECT
  exp(-b0 / b1) AS ld50,
  exp(-b0 / b1 - 1.96 * sqrt(v00 / (b1 * b1) + b0 * b0 * v11 / (b1 * b1 * b1 * b1) - 2 * b0 * c01 / (b1 * b1 * b1))) AS lower_95,
  exp(-b0 / b1 + 1.96 * sqrt(v00 / (b1 * b1) + b0 * b0 * v11 / (b1 * b1 * b1 * b1) - 2 * b0 * c01 / (b1 * b1 * b1))) AS upper_95
FROM coef, cov
このデータでは、LD50 の点推定は約 7.5 mg/L、95% 信頼区間は約 6.3 から 8.9 mg/L になります。
脚注
-
一致するのは係数と標準誤差までです。対数尤度には二項係数に由来する定数項が形式ごとに異なる値で入るため、AIC は形式をまたいで比較できません。AIC で比較するのは、同じ形式で当てはめたモデルどうしに限ります。 ↩
-
この信頼区間は、最尤推定量の漸近正規性にもとづく Wald 区間です。被覆確率 が名目水準の 95% に一致するのは大標本に限られます。計算方法と性質は GLM の基礎: 係数の標準誤差と信頼区間 を参照してください。 ↩
このページの Markdown 版もあります。