GLMM タブ
GLMM タブでは、グループ構造を持つデータにランダム切片モデル , を当てはめられます。
たとえば複数の学校から生徒のテスト結果を集めたデータでは、学校ごとの違いをランダム切片 で考慮しつつ、勉強時間などの固定効果 を推定できます。
このモデルは GLM にランダム効果を加えた拡張で、マルチレベルモデルとも呼ばれます。成績に学校内の相関があり、勉強時間が学校間で異なる場合、GLM で学校差を無視すると勉強時間の係数の標準誤差が過小推定され、信頼区間が実際より狭くなります。
数理的な背景は GLMM の基礎を参照してください。
基本的な使い方
GLMM を開く
メニューバーから Analysis > Mixed Effects Model (GLMM)... を選択します。
分析の設定
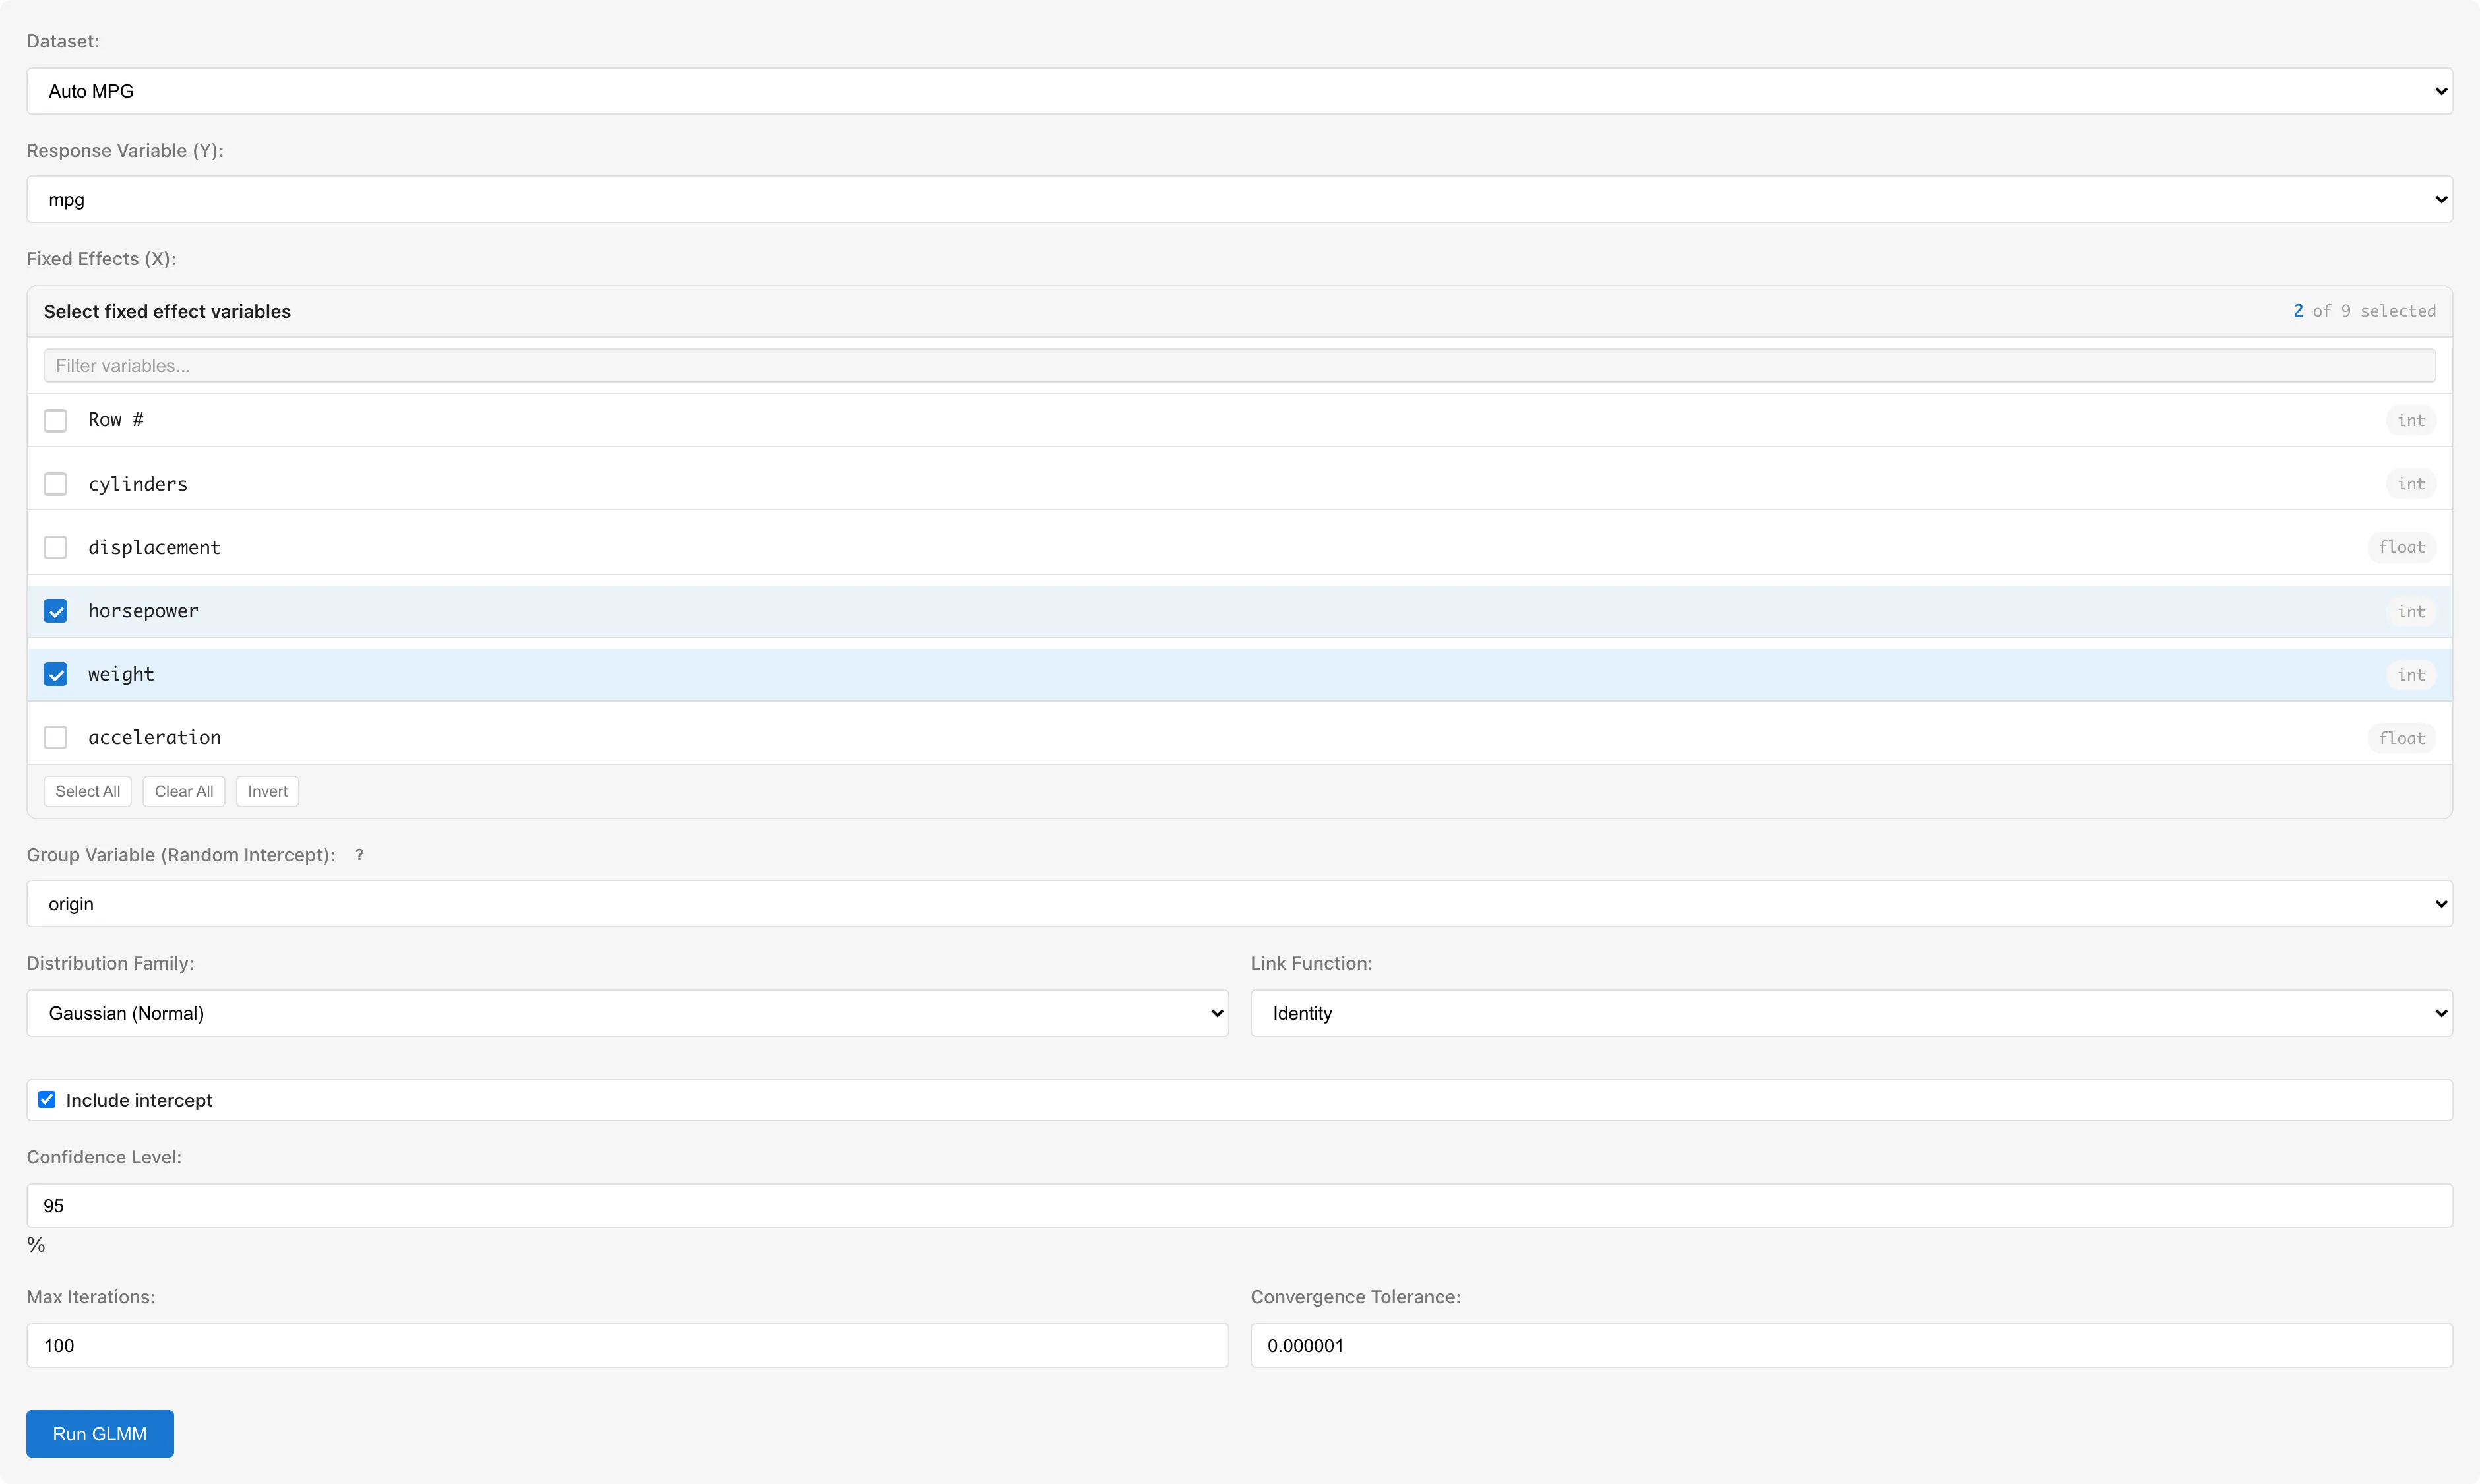
Dataset で分析対象のデータセットを選択します。GLMM は 1 行が 1 観測で、グループを示す列を持つデータを想定します。反復測定が複数の列に分かれている場合は Reshape タブの Wide to Long で変換できます。
Response Variable (Y) で応答変数を選択します。数値型(間隔・比率尺度)の列のみ選択できます。Binomial 分布族では 0/1 の値を持つ列を使用します。二値を boolean 型で持つ列は既定で名義尺度と推論されるため選択できませんが、Data Table で尺度を間隔尺度に変更すると選択でき、true=1, false=0 として扱われます。
Fixed Effects (X) で固定効果の説明変数を少なくとも 1 つ選択します。数値型の列のみ選択可能で、カテゴリ変数を使用する場合は事前に Dummy Coding で変換してください。変換結果は新しい派生データセットになるため、変換後は Dataset でそのデータセットを選び直します。
Group Variable (Random Intercept) でランダム切片のグループ変数を選択します。カテゴリ変数(名義・順序尺度)または文字列型の列が選択できます。ライン番号や学校 ID のようにグループを数値で記録している列は間隔尺度と推論されるため候補に表示されませんが、Data Table で尺度を名義尺度に変更すると選択できます。
Distribution Family で分布族を選択します:
| 分布族 | デフォルトリンク | 利用可能なリンク | 用途 |
|---|---|---|---|
| Gaussian (Normal) | Identity | Identity, Log | 連続値 |
| Binomial (Logistic) | Logit | Logit, Probit | 二値データ |
| Poisson (Count) | Log | Log, Identity | カウントデータ |
| Gamma | Inverse | Inverse, Log, Identity | 正の連続値 |
Link Function でリンク関数を選択します。分布族に応じたデフォルト(正準リンク)が設定されます。選択可能なリンク関数は分布族によって異なります(上記テーブルを参照)。
| リンク関数 | 数式 | 説明 |
|---|---|---|
| Identity | 変換なし。Gaussian の正準リンク | |
| Logit | 対数オッズ変換。Binomial の正準リンク | |
| Log | 対数変換。Poisson の正準リンク。 を保証 | |
| Inverse | 逆数変換。Gamma の正準リンク | |
| Probit | 標準正規分布の逆累積分布関数。潜在正規変数モデルに対応 |
正準リンクの数理的な性質は GLM の基礎: リンク関数の選択 を参照してください。
Include intercept で切片項の有無を設定します(デフォルト: オン)。
Confidence Level で信頼区間の信頼水準を設定します(デフォルト: 95%、範囲: 50--99.99%)。Fixed Effects テーブルの Lower N% / Upper N% 列に反映されます。保存後に Model Detail タブを開くと同じ入力が表示され、保存値を初期値としてその場で水準を変更できます(モデルに保存された値は変わりません)。
Max Iterations で最適化の最大反復回数を設定します(デフォルト: 100)。
Convergence Tolerance で収束判定の閾値を設定します(デフォルト: 1e-6)。
分析の実行
Run GLMM をクリックします。推定アルゴリズムは分布族によって異なります(詳細)。実行中はフォーム下部に進捗バーと推定のステージが表示されます。
実行後に変数選択やモデル設定を変えると、表示中の結果は現在の設定のものではなくなります。MIDAS はこの結果を画面から外し、再実行を促すメッセージを表示します。設定を元に戻すと結果は再び表示されます。Dataset を変えたときは変数選択も初期化されるため、結果は戻らずに破棄されます。Confidence Level の変更では結果を保持します。信頼水準は推定済みの係数から区間だけを計算し直す設定だからです。
実行後にフィットに使ったデータセットの内容が変わったときも、表示中の結果は現在のデータのものではなくなります。Reload Dataset・セルの編集・派生元データセットの変更がこれにあたります。MIDAS はこの結果を画面から外し、データセットが変更されたことを示すメッセージを表示します。この場合は設定を戻して結果を再表示する操作がないため、結果を得るには再実行が必要です。
結果の見方
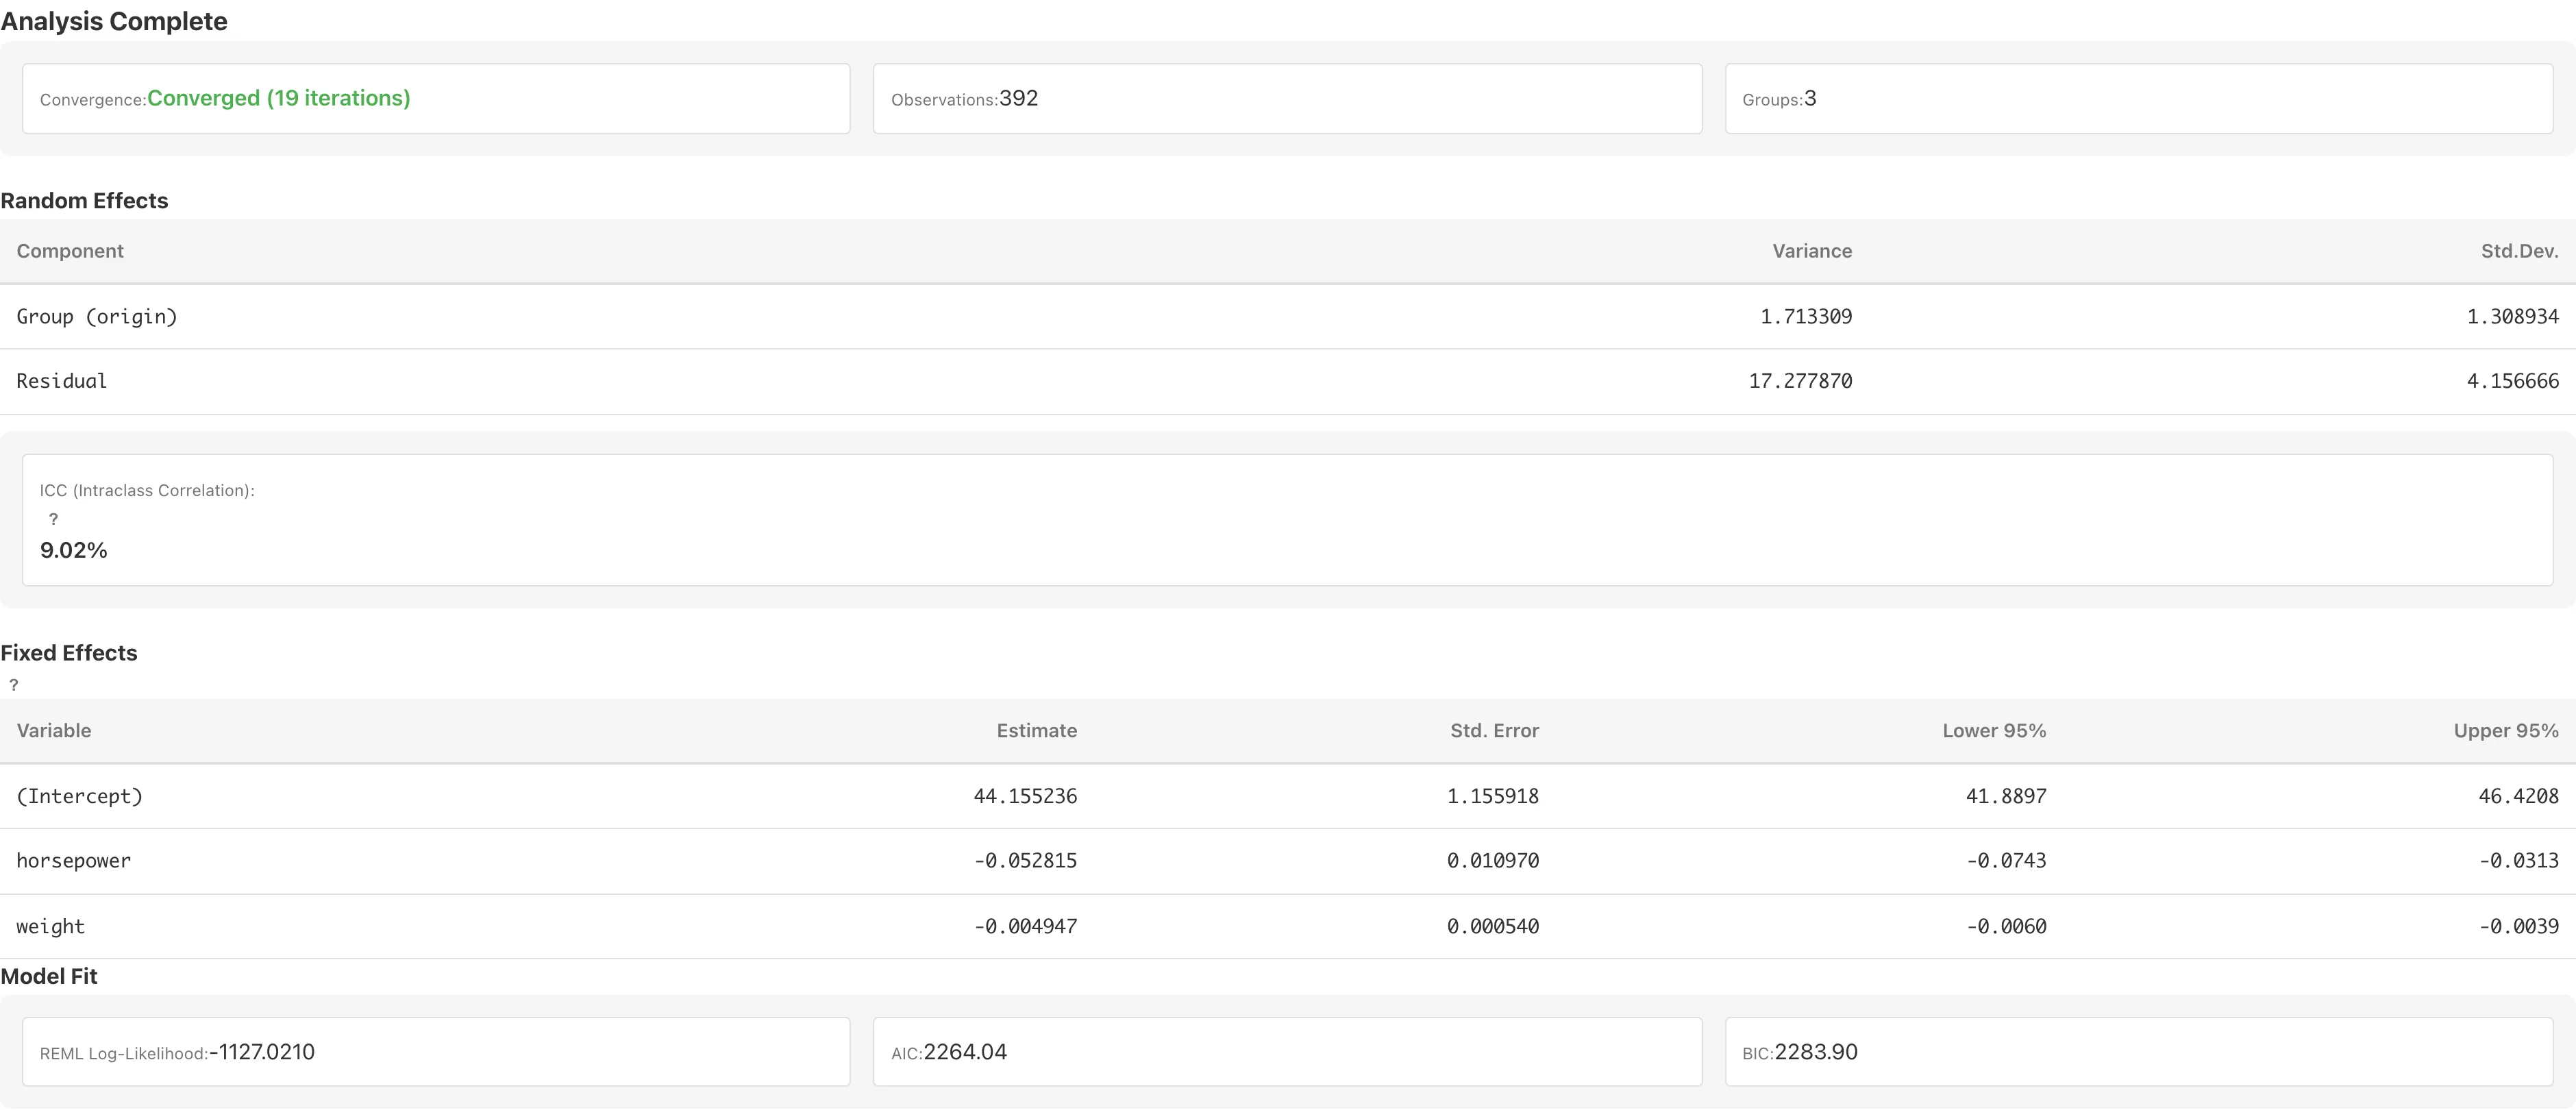
Random Effects・Fixed Effects・BLUP の各テーブルの数値列は、列ごとに表示形式を変更できます。既定は固定小数点表示で、BLUP の Rank 列だけは順位の値をそのまま表示します。列ヘッダを右クリックすると、固定小数点や有効数字などのプリセットから選べます。変更した表示形式はタブに保存され、モデルを再実行しても維持されます。
Random Effects
ランダム効果の分散成分を表示します。
| 列 | 説明 |
|---|---|
| Component | 分散成分の名前。Group (変数名) はグループ変数の分散、Residual は Gaussian の残差分散、Dispersion (φ) は Gamma の分散パラメータを表します |
| Variance | 推定値。グループ変数では 、Residual では 、Dispersion (φ) では です |
| Std.Dev. | Variance の平方根。Dispersion (φ) の行は、平方根が標準偏差にならないので計算不能を表す "-" です |
Poisson と Binomial 分布族では分散パラメータが 固定のため、Residual 行も Dispersion (φ) 行も表示されません。
分散成分の推定方法は分布族とリンクの組み合わせで異なります。Gaussian + identity の分散成分は REML 推定値です。それ以外の組み合わせでは、表示される分散成分はいずれも Laplace 近似した周辺尤度を最大にする最尤推定値です。このとき Residual 行と Dispersion (φ) 行の値は、分布族の分散パラメータ の推定値です。最尤推定値は、グループ数が少ないと分散成分を小さく見積もります(REML の節を参照)。推定の詳細は GLMM の基礎を参照してください。
分散パラメータ が何を表すかは、リンク関数によらず分布族で決まります。 と応答の条件付き分散の関係は分布族の性質だからです。Gaussian では なので、 は残差分散 そのものです。Gamma では なので、 は分散ではなく、その平方根は標準偏差ではありません。MIDAS が Gamma の行を Residual ではなく Dispersion (φ) と表示し、Std.Dev. を "-" にするのはこのためです。リンク関数は、線形予測子から fitted values を計算する経路を通じて、 の推定値と診断残差(deviance・Pearson)に影響します(モデルの保存と診断を参照)。
ICC(級内相関係数)
ICC は説明されない分散のうち、グループ間の違いが占める割合です()。MIDAS は に理論的根拠がある以下の family+link の組み合わせでのみ ICC を計算します:
それ以外の組み合わせ — Poisson(全リンク)、Gamma(全リンク)、Gaussian + log — では、理論的に根拠のある残差分散が存在しないため、ICC の値の代わりに N/A (ICC not defined) と表示されます(詳細は GLMM の基礎 を参照)。これらの組み合わせでも、グループ間変動の大きさは Random Effects テーブルの Variance(リンク尺度の )と BLUP で確認できます。
ICC が定義される組み合わせでも、分散成分の推定が破綻して ICC を計算できない場合は N/A (degenerate fit) と表示されます。
ICC の解釈はデータの性質や研究目的に依存し、グループサイズも考慮する必要があります(GLM との使い分けを参照)。
Binomial モデルの ICC は確率尺度ではなく潜在(リンク)尺度で計算されます。観測された二値応答の相関とは一致しません。
Fixed Effects
固定効果の係数テーブルです。
| 列 | 説明 |
|---|---|
| Variable | 変数名 |
| Estimate | 回帰係数 |
| Std. Error | 標準誤差。Gaussian + identity では分散成分を推定したことによる過小分を Kenward-Roger 法で補正した値です。補正が数値的に計算できない場合は警告を表示し、未調整の値になります。それ以外の組み合わせでは推定値での作業重み行列に基づく近似です |
| df | 信頼区間に使う t 分布の係数ごとの自由度です。Gaussian + identity で Kenward-Roger 補正が計算できたときだけ表示されます。計算できない係数は - と表示されます |
| Lower N% / Upper N% | Wald に基づく信頼区間の下限・上限です。N は選択した信頼水準に応じて変わります |
リンク関数が logit または log の場合、以下の列が追加されます。
| 列 | 説明 |
|---|---|
| OR / IRR / exp(Est.) | Estimate の指数変換 です。logit リンクではオッズ比(OR)、log リンク + Poisson では発生率比(IRR)、それ以外の log リンクでは exp(Est.) と表示されます |
| exp(Lower N%) / exp(Upper N%) | 信頼区間の指数変換です |
係数は GLM と同じくリンク関数のスケールで解釈します。詳しくは GLM の係数の解釈 を参照してください。
信頼区間の参照分布は family と link の組み合わせで異なります。Gaussian + identity では Kenward-Roger 法による係数ごとの自由度を持つ t 分布を使い、分散成分を推定したことによる不確実性を区間の幅に反映します。自由度が小さい係数は少ない情報で推定されており、その分だけ区間が広くなります。分散成分の構造が退化していて補正を計算できない場合は、警告を表示したうえで未調整の標準誤差と標準正規分布に切り替わります。それ以外の組み合わせでは標準正規分布を使うため、グループ数が少ない場合は信頼区間の幅が過小評価される傾向があります。詳細は GLMM の基礎: 固定効果の推測 を参照してください。
固定効果係数テーブルは Save as Dataset ボタンでデータセットとして保存し、CSV にエクスポートできます。Add to Report ボタンでレポートに追加すると、BLUP テーブルも同時に追加されます。どちらもモデルの保存が必要で、モデルが未保存のときは、ダイアログでモデル名を入力し、同じ操作の中でモデルを保存します。
Model Fit
| 指標 | 説明 |
|---|---|
| REML Log-Likelihood / Log-Likelihood (Laplace) | 対数尤度。Gaussian + identity では REML、それ以外の組み合わせでは Laplace 近似の周辺対数尤度です |
| AIC | 。 は固定効果の数と分散成分の数の合計です |
| BIC | 。 は観測数です |
AIC・BIC によるモデル比較には制約があります(GLMM の基礎: AIC/BIC の制限を参照)。REML 対数尤度(Gaussian + identity)に基づく AIC は固定効果の構造が同一のモデル間でしか比較できません。分布族またはリンクが異なるモデルどうしでは、対数尤度の基準(REML / Laplace)と尺度が変わるため、AIC・BIC・対数尤度を比較できません。
BLUP(ランダム効果の予測値)
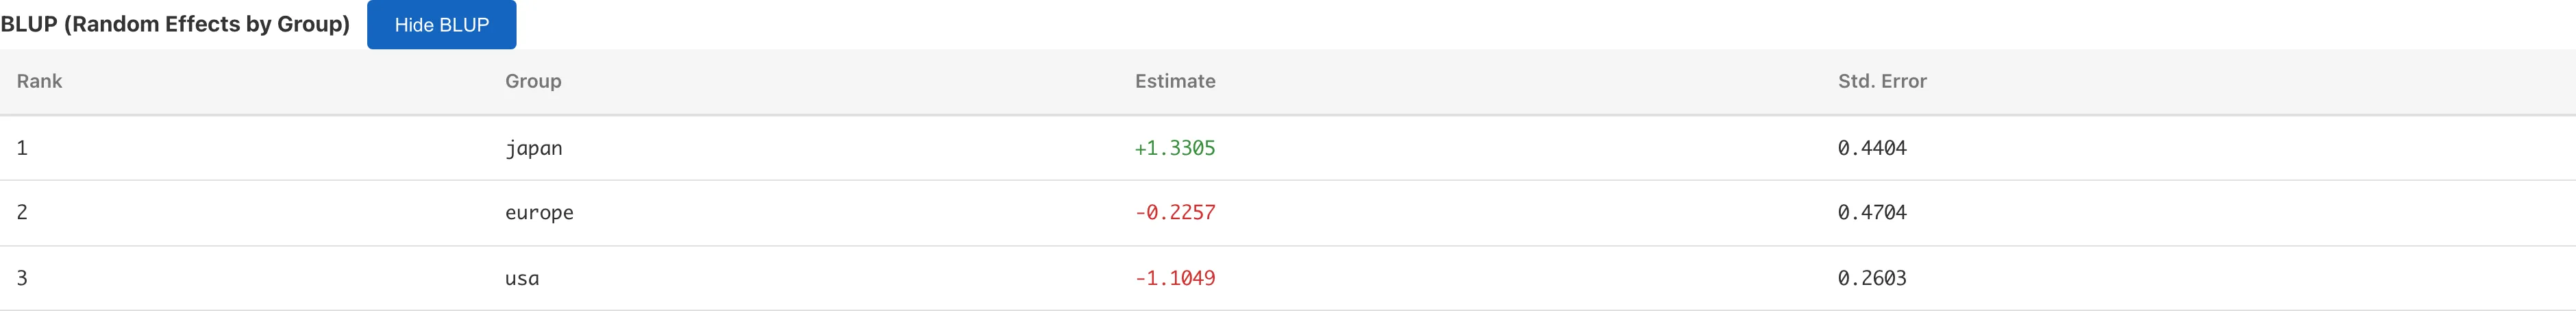
各グループのランダム切片の予測値 BLUP(Best Linear Unbiased Predictor、最良線形不偏予測量)を表示します。
| 列 | 説明 |
|---|---|
| Group | グループ変数の値 |
| Conditional Mode | ランダム効果 の予測値。グループサイズが小さいほど全体平均(0)に向かって縮小されます(縮小推定の詳細) |
| Std. Error | 予測値の標準誤差。条件付き分散の平方根で、グループサイズが小さいほど大きくなります |
| Rank | Conditional Mode の降順の順位 |
予測値が線形不偏予測量のなかで平均二乗予測誤差を最小にするという BLUP の性質が成り立つのは、Gaussian + identity の場合だけです。それ以外の組み合わせでは、予測値は観測データで条件づけた の分布の最頻値(条件付きモード)で、これが Conditional Mode 列に表示される値です(GLMM の基礎: 推定と予測を参照)。
Gaussian + identity 以外の Std. Error は条件付きモード周りの正規近似に基づく値のため、条件付きモード ± z × SE の形で作った区間は正確な予測区間になるとは限りません。
BLUP テーブルは Save as Dataset ボタンでデータセットとして保存し、CSV にエクスポートできます。BLUP データセットの保存にはモデルの保存が必要で、モデルが未保存のときは、ダイアログでモデル名も入力し、モデルとデータセットをまとめて保存します。レポートへの追加は Fixed Effects の Add to Report ボタンから行います。
モデルの保存と診断
Model Name にモデル名を入力し Save Model をクリックすると、モデルがプロジェクトに保存されます。保存時に診断用の派生データセットが自動生成されます。
| 列名 | 内容 |
|---|---|
fitted_values | 予測値(固定効果 + ランダム効果) |
deviance_residuals | Deviance 残差 |
pearson_residuals | Pearson 残差 |
group_random_effect | グループのランダム切片(BLUP) |
Gaussian + identity では deviance 残差と Pearson 残差はともに生の残差 に一致し、deviance_residuals と pearson_residuals は同じ値になります。
保存後、View Model Details と View Diagnostics ボタンが使えるようになります。Model Detail には固定効果の係数テーブルと BLUP テーブル(グループごとのランダム切片推定値)が表示されます。BLUP テーブルはデフォルトで 50 行まで表示され、グループ数が多い場合は Show all N rows ボタン(N は総グループ数)で全件を展開できます。Add to Report ボタンから係数テーブル・BLUP テーブルをレポートに追加できます。推定時に警告が出たモデルでは、Model Detail とレポートのどちらにも同じ警告が表示されます。
注意事項
現在の制約
GLMM の現在の実装はランダム切片モデルのみです。ランダム傾き(説明変数の効果がグループごとに変わるモデル)や交差ランダム効果(観測が複数のグループ変数に属するモデル)には対応していません(GLMM の基礎を参照)。
GLM タブでは Negative Binomial 分布族が利用できますが、GLMM タブでは対応していません。
GLM との使い分け
ICC が小さければ、グループ構造を無視して GLM で分析しても結果はほぼ変わりません。影響の大きさは ICC だけでなくグループサイズにも依存し、デザイン効果 が目安になります(GLMM の基礎を参照)。
ICC が大きい場合、GLM は観測間の独立性の仮定に反し、係数の標準誤差が歪みます。歪みの大きさは説明変数によって異なります。学校ごとの学費のように値の変動が主にグループ間にある説明変数ほど標準誤差は強く過小推定され、変動が主にグループ内にある説明変数では歪みは小さくなります。GLMM はグループ内の相関を明示的にモデル化することで、この問題を避けます。
比較したいグループが少数で、そのグループ自体の効果を直接推定したい場合は、グループを Dummy Coding でダミー変数に変換し、GLM の固定効果として扱う方法もあります(GLMM の基礎を参照)。
欠損値の自動除外
欠損値、非数値、無限大を含む行は自動的に除外されます。結果の Observations は除外後の観測数です。この除外はリストワイズ除去に該当します。妥当な推定を与える条件については 欠損データのメカニズム を参照してください。
収束の問題
収束しない場合は次の対処を試してください:
- Max Iterations を増やす(たとえば 100 から 500 へ)
- Convergence Tolerance を緩める(たとえば 1e-6 から 1e-4 へ)
- スケールが大きく異なる説明変数を標準化する
説明変数は内部でスケーリングされますが、スケール差が極端な場合は初期値を与える GLM の推定が失敗することがあります。また、グループ数が 2〜3 と極端に少ない場合は分散成分の推定が不安定になり、収束の問題が起きやすくなります。
Max Iterations が上限を決めるのは、 の探索のうち黄金分割法の反復だけです。探索範囲に置いた点での評価は点の数が決まっていて、この上限に数えません。 の候補ごとに固定効果とランダム効果を求める反復には別の上限があります。MIDAS は相対共分散パラメータ (GLMM の基礎を参照)の候補ごとに、PIRLS(Penalized IRLS)の反復で固定効果とランダム効果の出発点を求めます。そこから固定効果を反復で最適化します。 の探索が最後に絞り込んだ区間の中の候補でこの最適化が収束しないと、推定値を定められないので、MIDAS は当てはめをエラーで中止します。最終的に採用した で収束しなかった場合は、警告を付けて推定値を表示します。
Binomial で、説明変数が応答を完全に、またはほぼ完全に分ける(separation)データでは、固定効果の推定値が有限の値として存在しないので、MIDAS は当てはめをエラーで中止します。エラー文は、固定効果の最適化が収束しなかったことと separation の可能性を示すか、固定効果の連立方程式が数値的に特異になったことを示します。Max Iterations と Convergence Tolerance を変えても解決しないので、応答を完全に、またはほぼ完全に予測する説明変数を見直してください。
Gamma に Inverse リンクを使うと、線形予測子を正に保てない場合に適合がエラーで中止されます。Inverse リンクは平均を線形予測子の逆数とするので、線形予測子が 0 以下では正の平均が得られません。PIRLS は、線形予測子を 0 以下にする更新を、線形予測子が正に保たれるところまで縮めます。エラーになるのは、更新を縮めても線形予測子が正に戻らない場合と、初期値を与える GLM の推定が失敗して PIRLS が線形予測子 0 から始まる場合です。Log リンクは線形予測子がどの値でも正の平均を与えるため、この制約を持ちません。ただし Log リンクは平均を Inverse リンクとは異なるスケールでモデル化するので、係数の意味も変わります。
Singular Fit
ランダム効果の分散の推定値がパラメータ空間の境界である 0 に達した場合、"Singular fit" 警告が表示されます。MIDAS は、分散成分の最適化に使う相対共分散パラメータ (GLMM の基礎を参照)が を満たすときに singular fit と判定します。
MIDAS の singular fit の判定は、応答の単位によって変わりません。Gamma の Inverse リンクでは、応答を 倍すると線形予測子は 倍になり、Identity リンクでは 倍になるので、 も応答の単位に依存します。Gaussian + log では、応答を 倍しても線形予測子は定数 だけずれるだけです。しかし は 倍になるので、 は 倍になります。MIDAS はこれらの組み合わせと Gamma の Log リンクでは、応答を正の値 で割ってから推定し、その で判定します。Gamma の Log リンクの は応答の単位によりませんが、平均が極端に大きいか小さい単位では数値計算が単位に左右されるので、同じく応答を割ります。 は、Gamma では応答の平均、Gaussian + log では応答の絶対値の平均です。Log リンクでは、応答を で割ると平均の対数が だけ小さくなります。MIDAS は線形予測子に定数 を足して当てはめるので、係数は割る前のモデルと同じ値になります。推定値は元の単位に戻して表示します。
Singular fit は、グループ変数が応答変数の変動をほとんど説明していない場合や、グループレベルの変動と残差変動を分離するにはサンプルサイズやグループ数が足りない場合に起こります。 の探索が の境界の局所的な最大点に止まり、境界から離れた位置にある尤度のより高い最大点を見落とした場合にも起こります。探索が最大点を見落とす条件は GLMM の基礎で説明します。
Singular fit が発生した場合、ICC や分散成分の推定値は慎重に解釈する必要があります。固定効果のみのモデル(GLM)の方が適切な場合があります。
See also
このページの Markdown 版もあります。