予測精度の指標
予測精度の指標は、モデルの予測値を観測値と突き合わせて、予測の良さを数値で要約します。
適切な指標は応答のタイプによって変わります。連続値の応答には誤差の大きさを測る指標を、二値の応答には 0 と 1 の間の予測値を評価する専用の指標を使います。
指標の値は、評価に使うデータの選び方にも依存します。モデルは当てはめに使ったデータに最も合うように係数を選んでいます。そのため、同じデータで評価した指標は新しいデータで評価した値より良く出ます。モデルがデータの偶然の変動にまで合わせて当てはまることを過適合(overfitting)と呼び、過適合が強いほどこの差は大きくなります。新しいデータへの予測の良さを知りたい場合は、当てはめに使っていないデータで評価します。
RMSE と MAE
RMSE(Root Mean Squared Error、二乗平均平方根誤差)と MAE(Mean Absolute Error、平均絶対誤差)は、予測誤差の大きさを要約する指標です。どちらの値も応答変数と同じ単位を持ちます。
RMSE の分母は観測数 です。Linear Regression タブが表示する残差標準誤差は、同じ二乗誤差の和を残差自由度 で割る別の量であり、二乗誤差の和が 0 でない限り同じモデルでも値が異なります。
2 つの指標は、誤差が大きい観測への感度が違います。RMSE は誤差を二乗してから平均するため、大きい誤差ほど強く効きます。MAE は誤差の絶対値をそのまま平均します。同じデータでは RMSE は必ず MAE 以上になり、少数の大きい誤差が混じると RMSE のほうが大きく増えます。両者の開きが大きいときは、誤差の大きさが観測によって大きくばらついています。
R² と予測 R²
R² は、観測値の平均だけで予測する基準モデルに比べて、二乗誤差をどれだけ減らせたかの割合です。
1 に近いほど誤差が小さいことを示します。0 は平均で予測するのと同等で、負の値は平均で予測するより悪いことを示します1。
MIDAS が GLM 予測タブと GLM タブの当てはめ結果に表示する R² は、どちらも評価するデータ自身の観測値の平均 を基準にした予測 R² です。当てはめ結果の指標は当てはめに使ったデータ自身で評価するため in-sample の値になり、予測タブで別のデータセットを選んだ場合と違って、当てはめへの適合をそのまま反映します。当てはめデータでの R² が正でも、新しいデータへの予測 R² は負になりえます。
分散が平均に依存する応答と Mean Deviance
分散が平均に依存する分布族(Poisson の 、Gamma の など)では、二乗誤差にもとづく指標が当てはまりの評価として誤解を招きます。そのため MIDAS はこれらの分布族で R² を表示しません。二乗誤差にもとづく指標は、すべての観測の誤差を同じ重みで平均します。これらの分布族では平均の大きい観測ほど自然なばらつきも大きくなります。そのため二乗誤差の合計の大部分を平均の大きい観測が占め、R² は平均の大きい観測への当てはまりだけを反映した値になります。
Mean Deviance は、評価データに対する 逸脱度 を観測数 で割った値です。
逸脱度は分布族の尤度にもとづいて観測と予測の食い違いを測るため、分散が平均に依存する分布族でも、平均の大きい観測に偏らずに誤差を要約できます。値が小さいほど予測が観測に近いことを示します2。値の水準は応答の単位と分布族に依存するため、単独で良し悪しを判定する基準はありません。同じ分布族・同じ評価データでのモデル間の比較に使います。
Brier Score
二値応答のモデルは、観測ごとに 0 と 1 の間の予測値を出力します。Brier Score は、この予測値を 1 が起きる確率として評価する指標です。観測値(0 または 1)と予測値の二乗差の平均として計算します。
0 に近いほど予測値が観測に近いことを示します。比較の基準は、観測を区別せず、どの観測にも 1 の割合 を割り当てる予測です。この予測の Brier Score は になります。値は 1 と 0 が半々のとき最大の 0.25 で、割合が偏るほど小さくなります。モデルの Brier Score がこの水準以上のときは、割合を一律に予測するのと比べて予測が改善していないことを示します。
ROC 曲線と AUC
予測値から 0/1 の判定を作ると、2 種類の誤りが、しきい値の選び方に応じたトレードオフの関係になります。判定は、しきい値を決めることで得られます。予測値がしきい値を超えた観測を 1、それ以外を 0 とみなします。誤りには、0 の観測を 1 と判定する誤りと、1 の観測を 0 と判定する見逃しの 2 種類があります。しきい値を下げるほど多くの観測が 1 と判定されるため、見逃しは減ります。一方で、0 を 1 とする誤りは増えます。
ROC 曲線は、このトレードオフの全体を 1 本の曲線として描いたものです。横軸には 0 の観測のうち 1 と判定された割合を、縦軸には 1 の観測のうち 1 と判定された割合をとります。しきい値を最大から最小まで動かしたときの点の軌跡が曲線になります。曲線は、どの観測も 1 と判定しない左下の点から、すべての観測を 1 と判定する右上の点へ進みます。識別性能の高いモデルほど、0 をほとんど 1 と誤らないうちに 1 の大半を検出できるため、曲線は左上の角に近づきます。
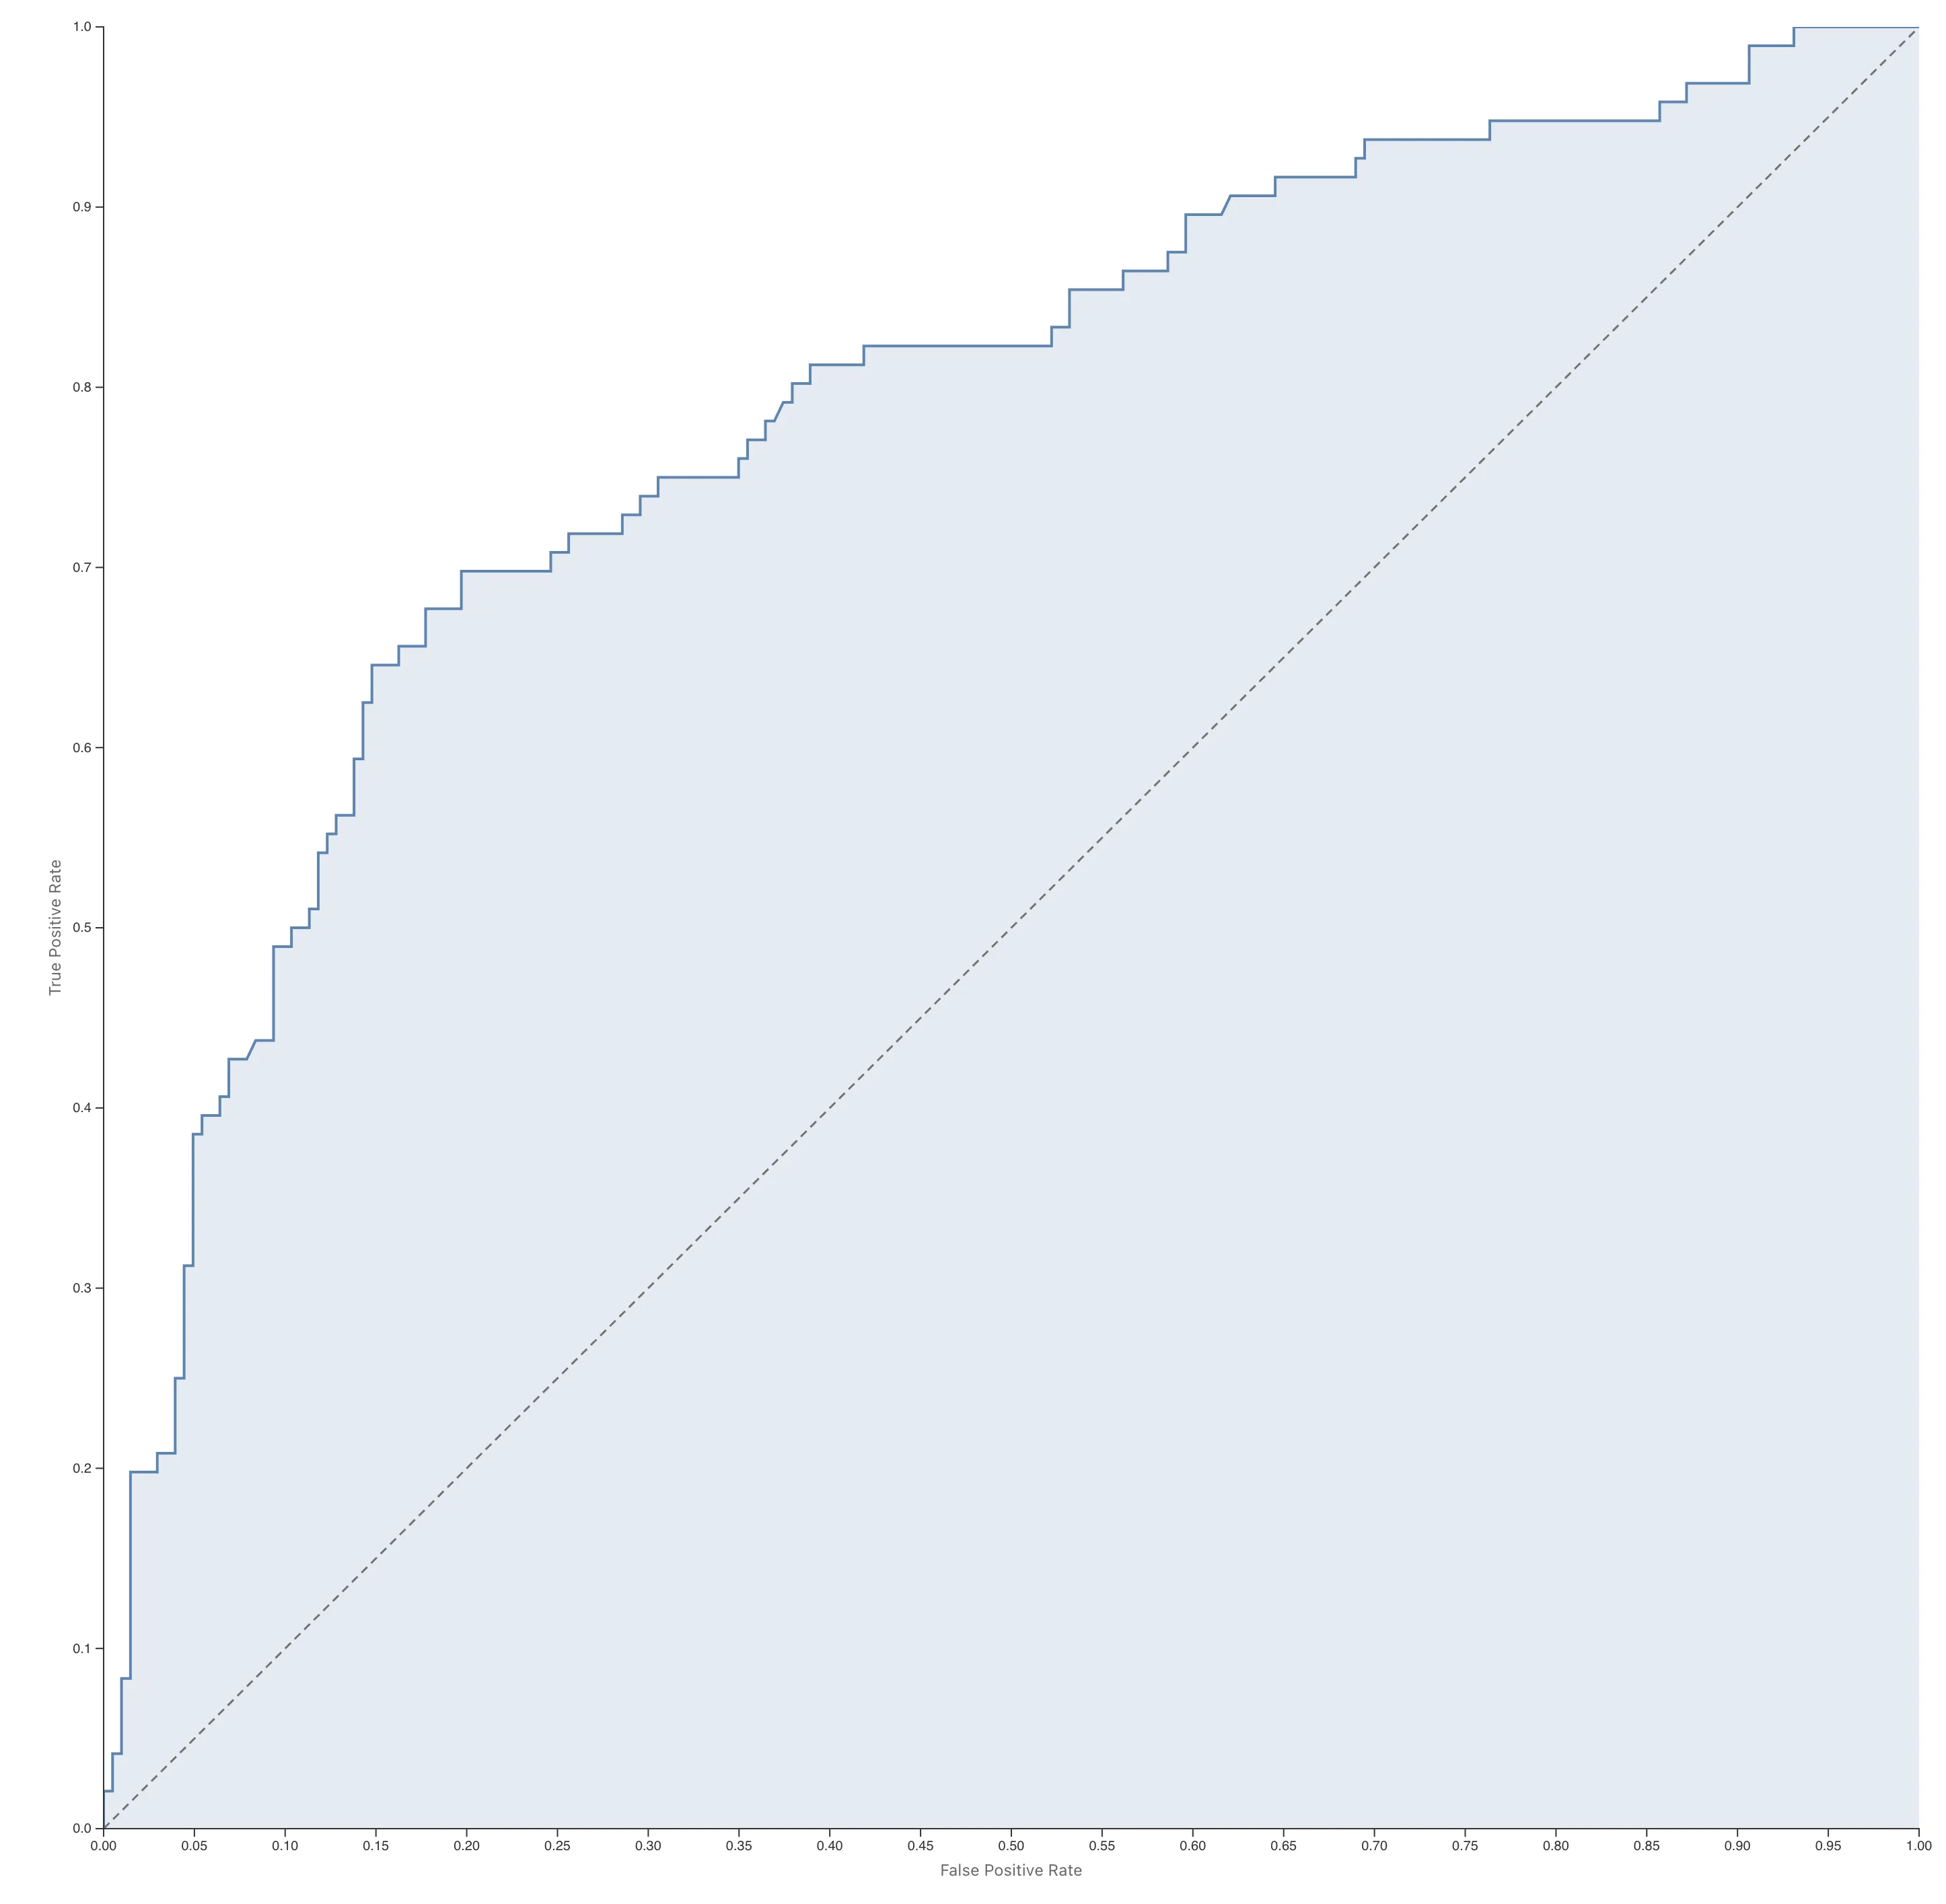
図は、サンプルデータ Heart Failure の死亡(列 DEATH_EVENT)を age・ejection_fraction・serum_creatinine で予測する Binomial GLM の ROC 曲線です。予測値は、当てはめに使ったデータ自身への予測です。破線の対角線は無作為な振り分けに対応します。予測値によらず一定の確率で 1 と判定する振り分けでは、0 の観測のうち 1 と判定される割合も、1 の観測のうち 1 と判定される割合も、その確率に一致するためです。
AUC(Area Under the Curve)は ROC 曲線の下の面積で、モデルの識別能力をしきい値の選択に依存せずに要約します。上の図では、塗りつぶした領域の面積が AUC です。1.0 は、あるしきい値を選べばそれ以下の観測はすべて 0、それより大きい観測はすべて 1 と完全に識別できる状態です。0.5 は無作為な振り分けと同等の状態です。どのしきい値を選ぶかは、2 種類の誤りの重大さを比べて決める分析の外の判断です。AUC はその判断の前に、モデルがどれだけ良いトレードオフを達成できるかを測ります。
AUC は予測値をしきい値と比べる点数として使うだけで、確率としての値そのものは評価しません。たとえば 1 の観測すべてに 0.9、0 の観測すべてに 0.8 を与えるモデルは、しきい値を 0.85 に置けば完全に識別できるため AUC は 1.0 です。一方でこのモデルの Brier Score は、1 と 0 が半々のデータで 0.325 と、どの観測にも 0.5 を割り当てる予測の 0.25 より悪くなります。確率の値の正確さを見たいときは Brier Score を使います。
成功数と試行数の形式(Grouped Binomial)で当てはめたモデルでは、各行を試行数分の 0/1 観測とみなし、Brier Score と AUC を試行数で重み付けして計算します。個体ごとの 0/1 データは試行数 1 の場合にあたり、同じ式で計算されます。
See also
- GLM タブ: 予測精度指標 — 分布族ごとにどの指標が表示されるか
- GLM タブ: 当てはめデータでの予測精度指標 — 当てはめ直後の in-sample 表示
- GLM の基礎: 分散関数と過分散 — 分散が平均に依存する分布族の数理
- 統計用語集: 逸脱度 — 逸脱度の定義
脚注
このページの Markdown 版もあります。