Cox Regression タブ
Cox Regression タブでは、共変量がハザードに与える効果を推定するセミパラメトリックな Cox 比例ハザードモデルを適合できます(定式化と理論)。複数の変数が生存時間に与える影響を同時に評価します。数理的な背景は生存分析の基礎を参照してください。
単一のカテゴリ変数による群間比較には Kaplan-Meier タブを使用してください。
データの準備
Cox 回帰には時間変数・イベント変数と、1つ以上の共変量が必要です。
- 時間変数: イベント発生までの時間(数値型)
- イベント変数: イベントが発生したかどうかを示す変数。以下の形式に対応しています:
- int64 型: 1 = イベント発生、0 = 打ち切り
- boolean 型: true = イベント発生、false = 打ち切り
- 共変量: 間隔・比率尺度の数値型の列
float64 型の列はイベント変数として選択できません。0/1 を小数として保持している列は、Convert Column Types タブ で int64 に変換してください。
MIDAS はイベント変数の値として 0 と 1(boolean 型では false と true)だけを受け付けます。それ以外の値を含む列で実行すると、MIDAS はどの値が何行あるかをエラーとして表示し、分析を実行しません。1 = 打ち切り、2 = イベント発生のような別のコーディングを使うデータは、SQL Query Editor タブ で 0/1 に変換してください。
MIDAS は時間変数の値として正の値だけを受け付けます。負の値やゼロを含む列で実行すると、MIDAS はどの値が何行あるかをエラーとして表示し、分析を実行しません。
尺度が nominal または ordinal に設定された列と date/datetime 型の列は共変量の一覧でグレーアウト表示され、選択できません。3値以上のカテゴリ変数を共変量として使うには、事前に Dummy Coding で数値変換してください。二値を boolean 型で持つ列は既定で名義尺度と推論されるため選択できません。Data Table で尺度を間隔尺度に変更すると選択できます。
打ち切りの扱いについては生存分析の基礎を参照してください。MIDAS が対応する打ち切りは右打ち切りのみです。左打ち切り・区間打ち切り・競合リスクには対応していません。
基本的な使い方
- メニューバーから Analysis > Survival Analysis > Cox Regression... を選択
- Time Variable で時間変数を選択
- Event Variable でイベント変数を選択
- Covariates で共変量を1つ以上選択
- Run Analysis をクリック
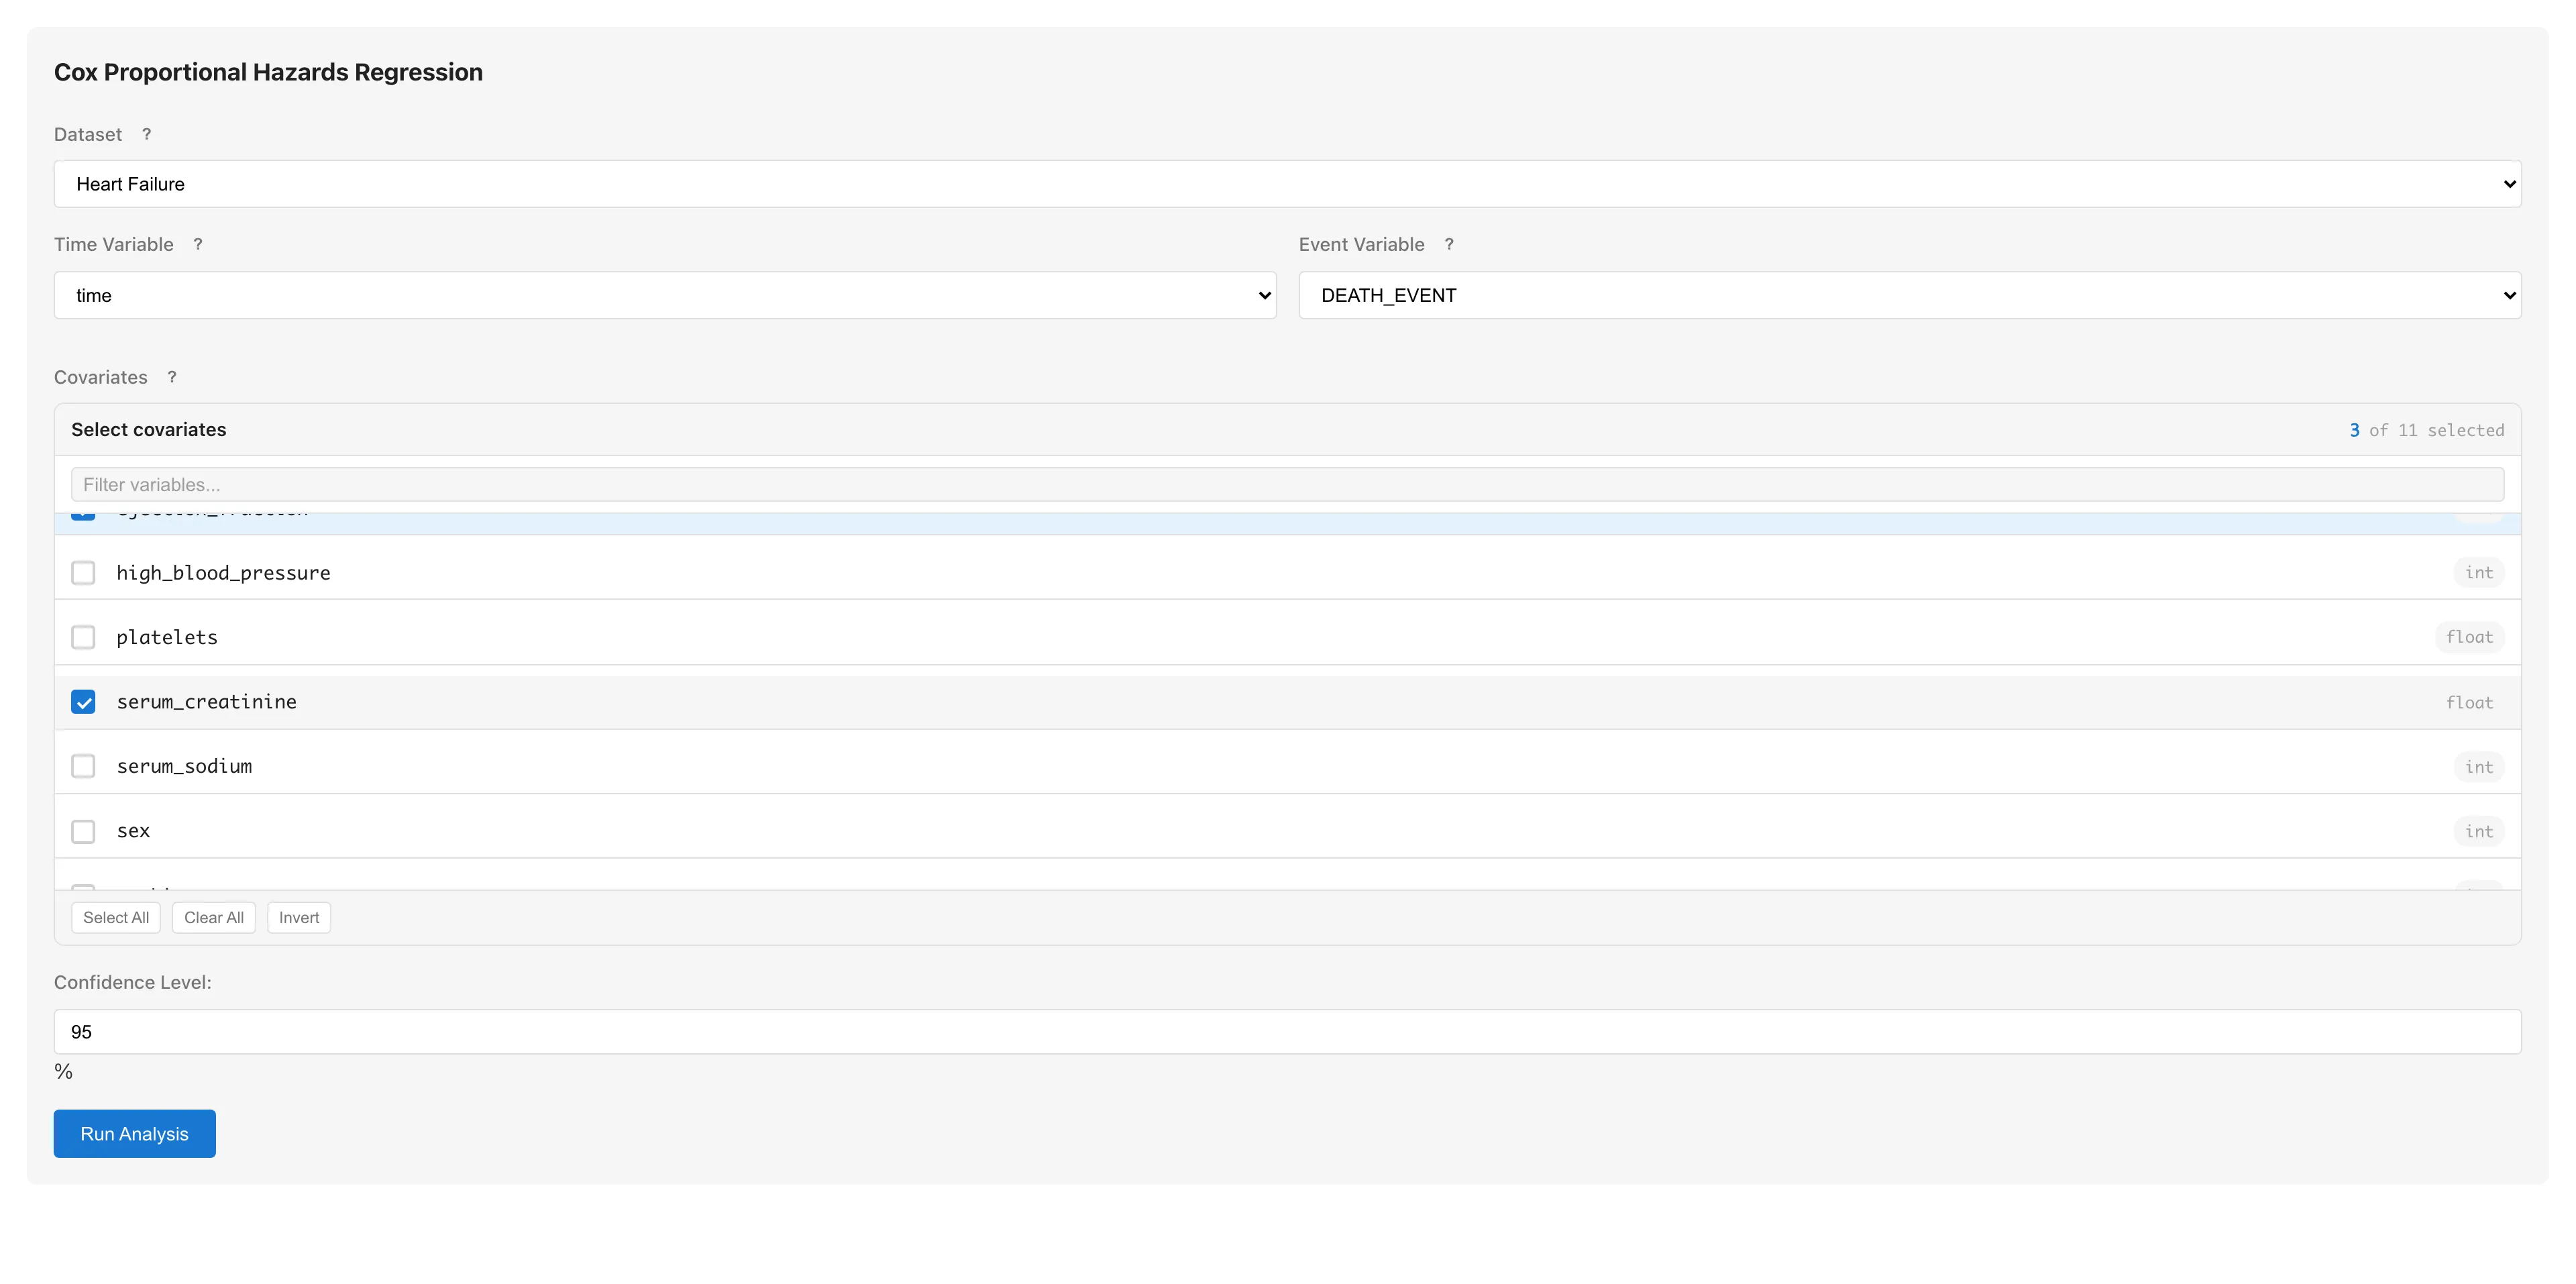
実行後に変数選択や共変量を変えると、表示中の結果は現在の設定のものではなくなります。MIDAS はこの結果を画面から外し、再実行を促すメッセージを表示します。設定を元に戻すと結果は再び表示されます。Dataset を変えたときは変数選択も初期化されるため、結果は戻らずに破棄されます。Confidence Level の変更では結果を保持します。信頼水準は推定済みの係数から区間だけを計算し直す設定だからです。
実行後に分析に使ったデータセットの内容が変わったときも、表示中の結果は現在のデータのものではなくなります。Reload Dataset・セルの編集・派生元データセットの変更がこれにあたります。MIDAS はこの結果を画面から外し、データセットが変更されたことを示すメッセージを表示します。この場合は設定を戻して結果を再表示する操作がないため、結果を得るには再実行が必要です。
結果の見方
Cox Proportional Hazards Regression
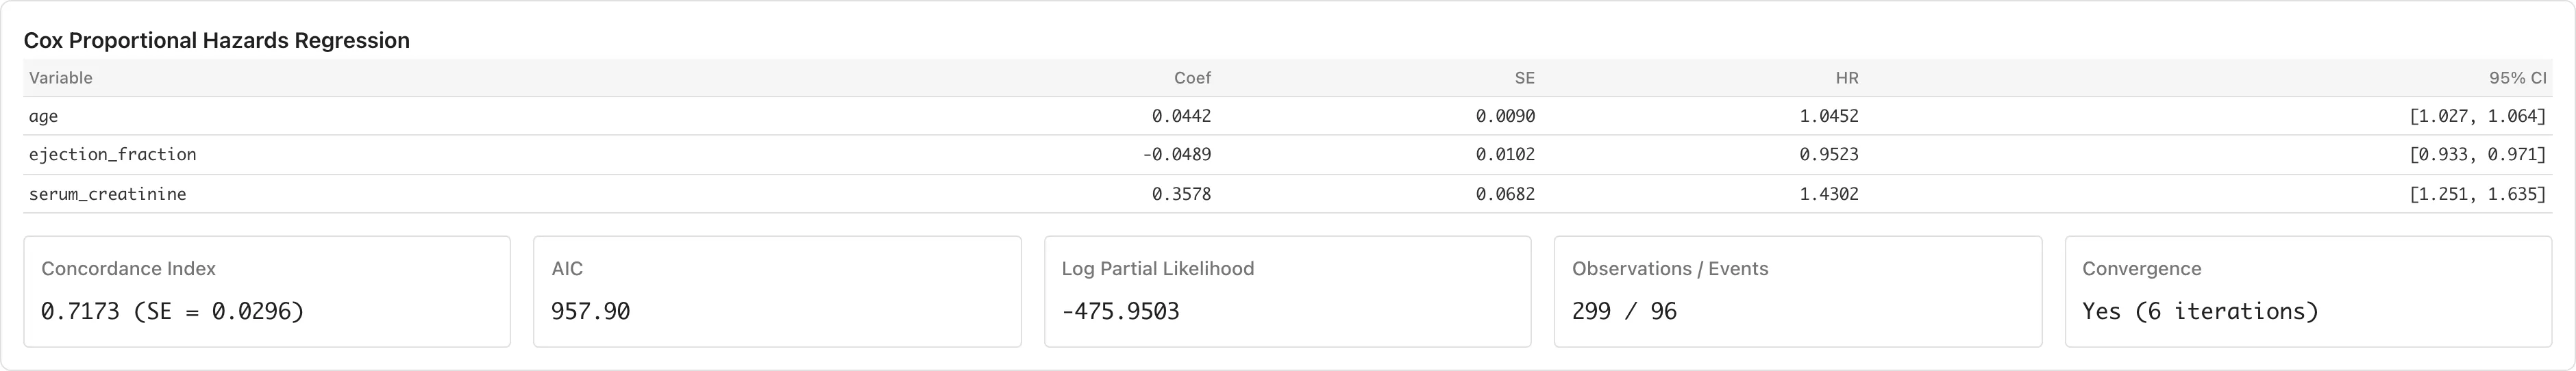
上段の係数テーブルには共変量ごとに以下の列が表示されます。
| 列 | 説明 |
|---|---|
| Variable | 変数名 |
| Coef | 回帰係数 |
| SE | 標準誤差 |
| HR | ハザード比 |
| CI | ハザード比の信頼区間。列ヘッダは選択した信頼水準に応じて変わります(例: "95% CI") |
ハザード比が1より大きい場合、その共変量が増えるとハザードが上昇します。1より小さい場合はハザードが低下します。詳しい解釈は生存分析の基礎を参照してください。
下段にはモデルの適合度指標が報告されます。
| 指標 | 説明 |
|---|---|
| Concordance Index | Harrell's C 統計量。比較可能なペアのうち、リスクスコアの順序がイベント順序と一致する割合です。0.5 が無情報、1.0 が完全な判別を意味します。括弧内は影響関数に基づく標準誤差です |
| AIC | 赤池情報量規準()。 は部分対数尤度、 は係数の数です。モデル比較に使います |
| Log Partial Likelihood | 部分対数尤度 。AIC の基礎となる値です |
| Convergence | 反復計算が収束したか(Yes / No)と、開始した反復の回数です |
反復計算が収束判定を満たす前に止まった場合、MIDAS は最大部分尤度推定を前提とする値を表示しません。係数テーブルは Variable と Coef at Last Iteration の 2 列になり、Coef at Last Iteration 列には反復が止まった時点の係数を表示します。この値は推定値ではありません。適合度指標は Log Partial Likelihood at Last Iteration、Observations / Events、Convergence だけになり、調整生存曲線、ベースライン累積ハザード、比例ハザード仮定の診断も表示しません。反復が止まる理由と確認すべき点は注意事項で説明します。
Adjusted Survival Curve
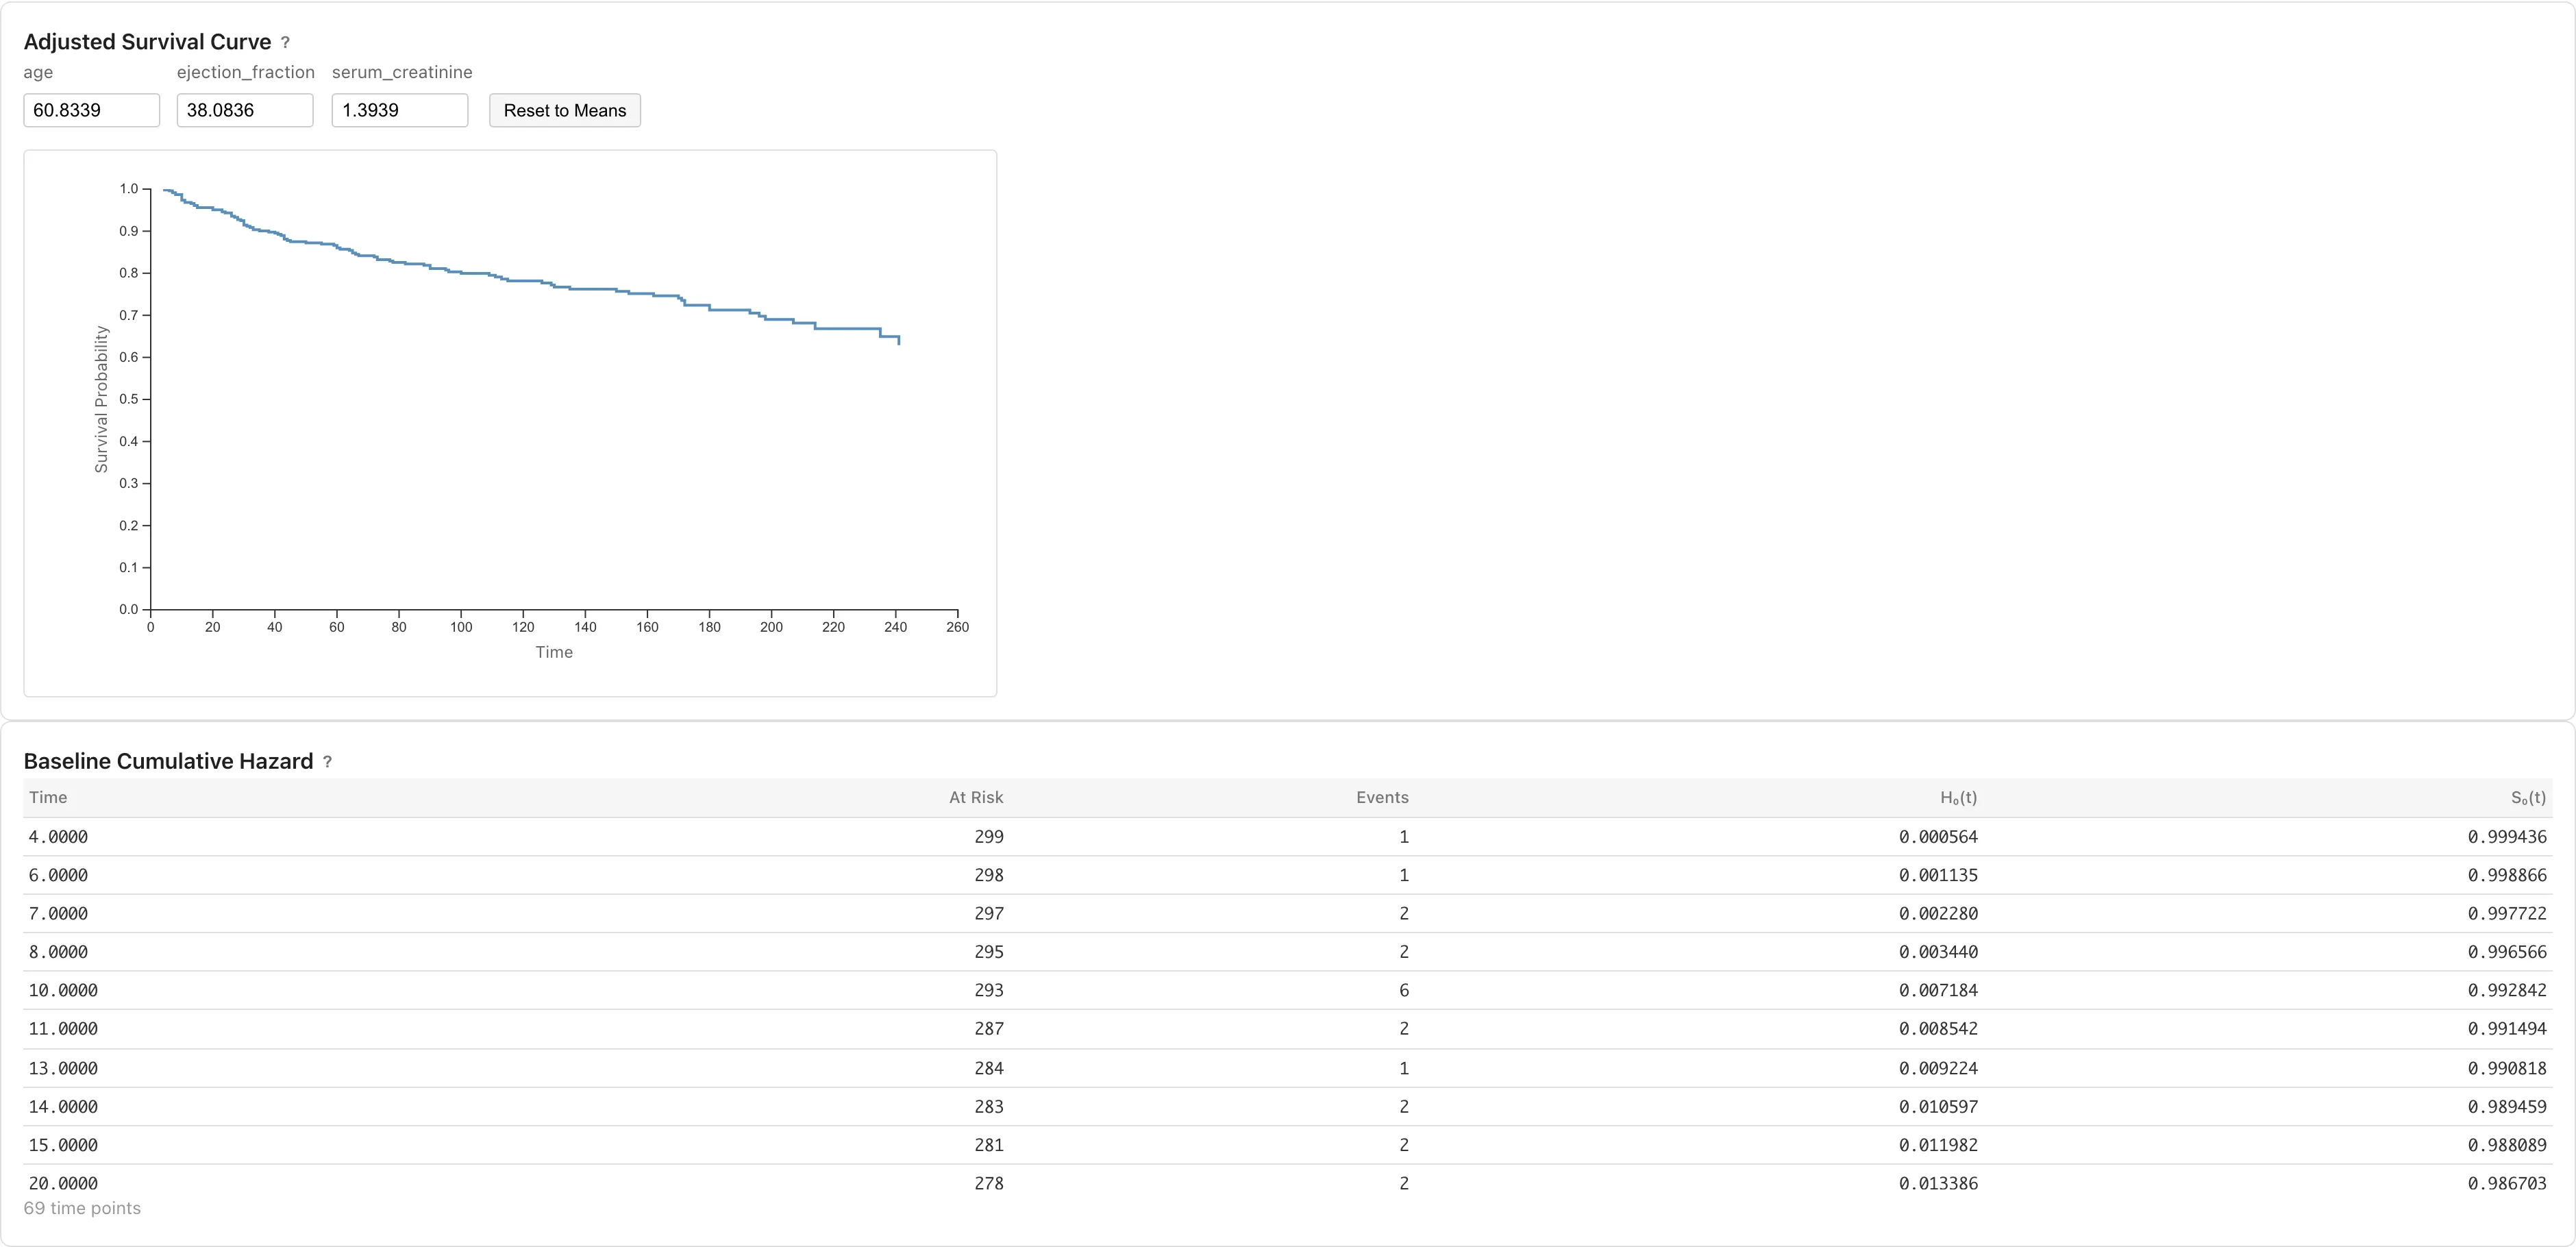
調整生存曲線は、指定した共変量値 に対する予測生存確率 を表示します。ベースライン累積ハザードと推定係数から計算されます(定式化)。
各共変量に入力欄があり、初期値は標本平均です。値を変更すると、その共変量プロファイルに対する予測生存曲線が即座に更新されます。Reset to Means で初期値に戻せます。
曲線を囲む帯は、Confidence Level で選んだ信頼水準での の pointwise 信頼帯です。信頼水準は係数テーブルと共有します。pointwise 信頼帯は各時点で個別に構成した区間であり、曲線全体の同時被覆を保証するものではありません。各区間の分散はベースラインハザードの増分と推定係数の 2 つの不確実性を合わせたものなので、帯はリスク集合が小さくなる追跡後期ほど広がり、共変量値が観測データから離れるほどさらに広がります(定式化)。一部の時点で区間を計算できない場合、MIDAS はその時点の帯を省き、プロットの上に注記を表示します。
標本平均を並べた初期プロファイルは計算の基準点であり、集団の記述ではありません。二値やカテゴリカルの共変量では、標本平均(0/1 の共変量での 0.4 など)はどの観測個体にも対応しません。また、平均の共変量値での曲線は、個体ごとの生存曲線の平均とも一致しません。特定の群を記述したい場合は、その群を定める共変量値を入力してください。
一部の時点で生存確率が計算できない場合、MIDAS はその時点を曲線から省き、省いた時点数の注記をプロットの上に表示します。
Baseline Cumulative Hazard
調整生存曲線の下に、ベースライン累積ハザードのテーブルが各イベント時点の値を表示します。
| 列 | 説明 |
|---|---|
| Time | イベント発生時間 |
| At Risk | リスク集合の人数 |
| Events | イベント発生数 |
| H₀(t) | 累積ベースラインハザード |
| H₀(t) nn% CI | 選んだ信頼水準での の pointwise 信頼区間。[下限, 上限] の形式で表示します |
| S₀(t) | ベースライン生存関数 |
| S₀(t) nn% CI | の pointwise 信頼区間。 の区間を で写したものです |
信頼区間の水準は係数テーブルと共有し、区間は全共変量がゼロのプロファイルでの調整生存曲線の区間と同じものです(定式化)。各時点で個別に構成した区間であり、同時信頼帯ではありません。区間を計算できない時点は "-" と表示します。
ベースラインは全共変量がゼロの状態に対応します。変数のスケールによってはゼロが非現実的な場合があるため、その場合は調整生存曲線で標本平均などの現実的な共変量値を指定して を確認するのが実用的です。
全共変量がゼロの点が観測データから遠いと、 が表示桁のすべての時点で 0 または 1 になることがあります。この場合、MIDAS はテーブルの上に注記を表示し、調整生存曲線の利用を案内します。
比例ハザード仮定の診断
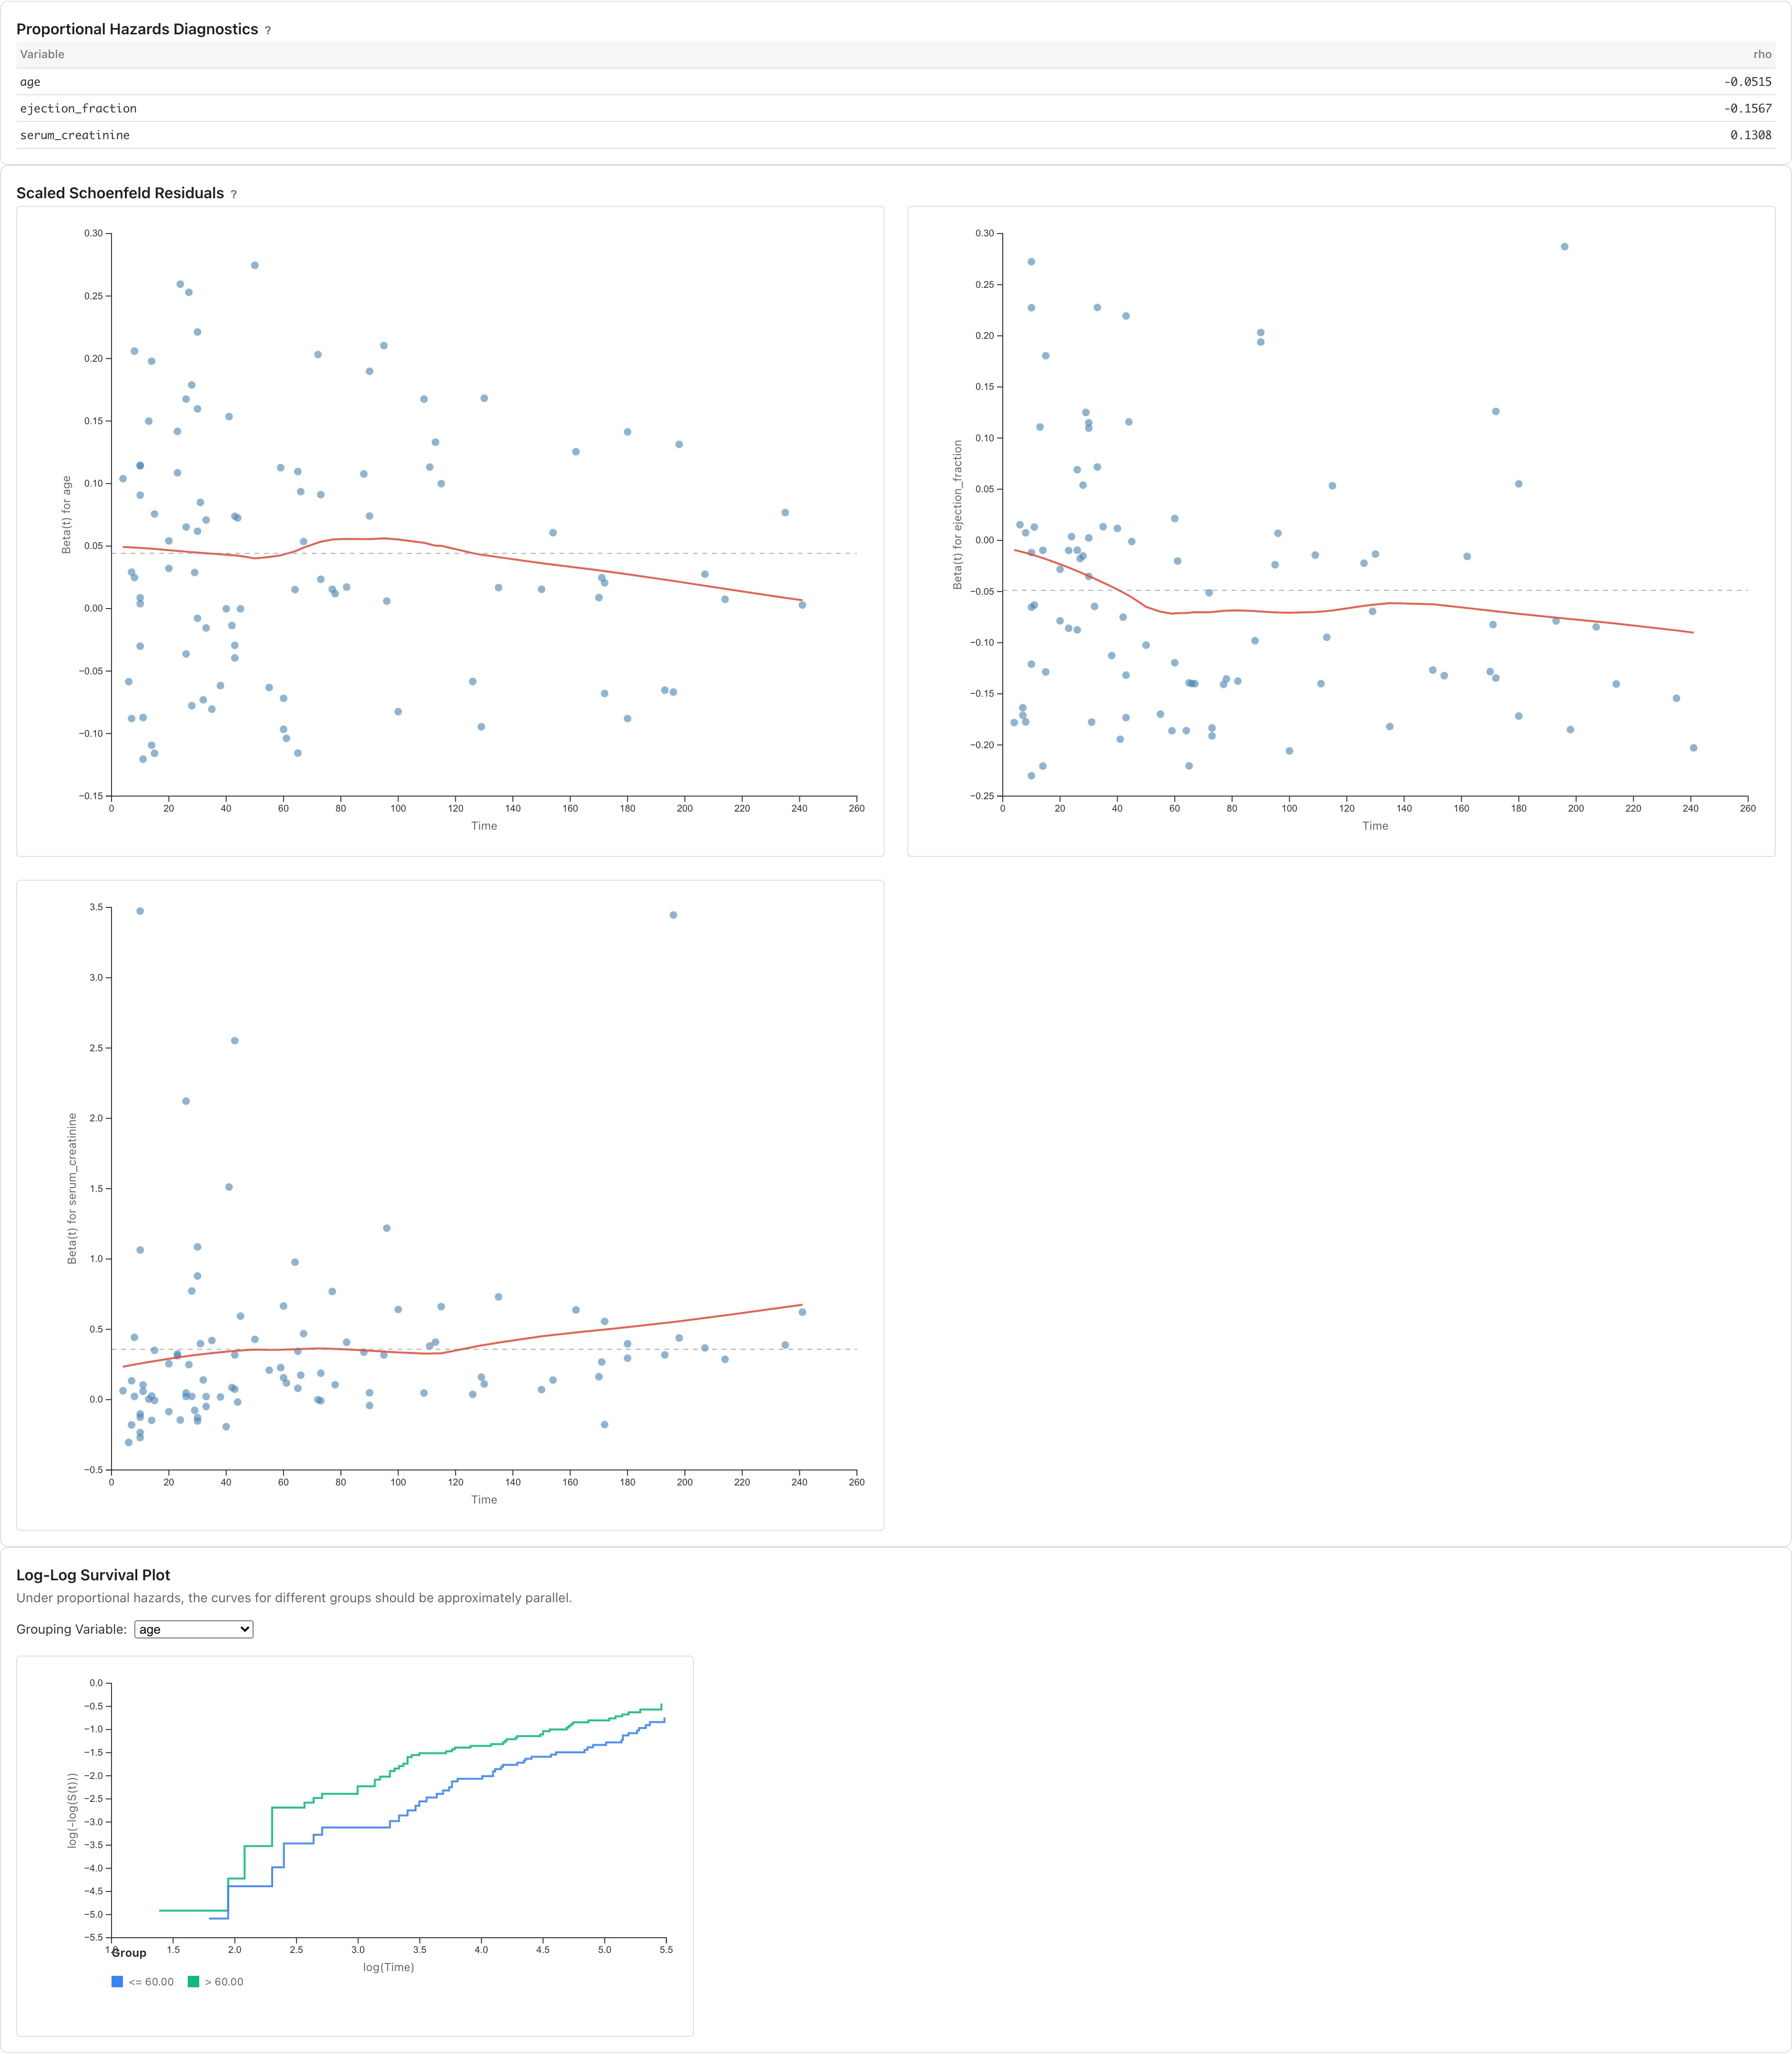
係数テーブルと適合度指標の下に、比例ハザード仮定の診断結果が表示されます。Cox モデルは共変量の効果が時間によらず一定であること、すなわち比例ハザード仮定を前提としています(詳細)。この仮定が崩れると、 は時間を通じた加重平均としてしか解釈できなくなります。
Proportional Hazards Diagnostics
スケーリング済み Schoenfeld 残差と時間の相関を共変量ごとに表示します(Grambsch & Therneau, 1994)。時間変換として KM 変換 を使用します。
| 列 | 説明 |
|---|---|
| Variable | 変数名 |
| rho | スケーリング済み Schoenfeld 残差と Kaplan-Meier 推定に基づく時間変換値の Pearson 相関係数。0 に近いほど仮定と整合的です |
rho の絶対値が大きい共変量は、効果が時間とともに変化している可能性があります。rho だけでは逸脱の程度やパターンは分からないため、下の Schoenfeld 残差プロットと合わせて判断してください。MIDAS は rho とプロットによる視覚的な判断を採用しており、検定統計量や p 値は表示しません。
MIDAS は rho を計算できない場合があります。スケーリング済み Schoenfeld 残差と時間変換のいずれかが一定値になると、Pearson 相関係数の分母が 0 になるためです。イベントが 2 件未満の場合と、すべてのイベントが同一時刻に発生する場合がこれにあたります。MIDAS はこのとき rho を「-」と表示します。
Scaled Schoenfeld Residuals
共変量ごとに、スケーリング済み Schoenfeld 残差を時間に対してプロットします。赤い曲線は LOESS による局所回帰線、灰色の破線は推定された係数 です。比例ハザード仮定が成り立つ場合、残差は の周りにランダムに散らばり、LOESS 線は水平に近くなります。LOESS 線が右上がりや右下がりの傾向を示す場合、その共変量の効果が時間とともに変化していることを示します。
Log-Log Survival Plot
群別の Kaplan-Meier 推定値を 対 にプロットします。Grouping Variable ドロップダウンでグルーピングに使う共変量を選択してください。選択した共変量の異なる値が 5 個以下の場合は値ごとに群を作ります。6 個以上の場合は中央値で 2 群に分割し、中央値と等しい値は「<=」側の群に入れます。中央値が最大値と一致すると「>」側に入る観測がなく、群は 1 つしかできません。このときと、生存確率が 0 と 1 の間に入るイベント時点を 2 つ以上持たない群があるときは、MIDAS がプロットの上に注記を表示します。前者では比べる曲線がなく、後者の群は曲線も凡例も描かれません。
2 つの群のハザードが比例するとき、両群の は対数ハザード比だけ縦にずれた平行な曲線になります。Kaplan-Meier 推定値はこの曲線の周りで変動し、リスク集合に残る対象が少ない時点ほど変動が大きくなります。そのため、曲線の端に見える交差や間隔の変化は標本の変動によることがあります。
この平行性は、モデルの比例ハザード仮定とは別のものです。モデルの比例ハザード仮定は全共変量を条件とした仮定ですが、各群の曲線は群ごとに計算した推定値で、モデルの他の共変量では調整していません。他の共変量がハザードに影響する場合や、中央値分割のように 1 つの群が異なる共変量の値を含む場合、群別の曲線は仮定が成り立っていても平行になるとは限りません。逆に、曲線が平行であっても仮定が成り立っているとは限りません。
中央値による分割は便宜的なもので、連続変数の情報を一部失うほか、元の連続変数としての非比例性を見逃す(または逆に強調する)ことがあります。連続変数の比例ハザード仮定の診断には、上の Schoenfeld 残差プロットの方が適しています。
上記の診断から比例ハザード仮定の違反が疑われる場合、層別 Cox モデルや時間依存共変量モデルで対処できますが、MIDAS は現在これらに対応していません。違反の程度と分析目的を踏まえて結果の解釈に注意してください。単一のカテゴリ変数による群間比較が目的であれば、比例ハザード仮定を前提としない Kaplan-Meier と RMST による比較が代替になります。ただし共変量の調整はできません。
注意事項
- 同着イベント(同じ時間に複数のイベント)の処理には Efron 法を使用します(詳細)
- 収束しなかった場合: 部分尤度を最大化する反復計算は、収束判定を満たす前に 3 つの理由のいずれかで止まることがあり、MIDAS は該当する理由を警告に示します。1 つ目は反復回数が上限の 100 回に達した場合です。2 つ目は、更新の方向に試した 10 通りの幅のいずれでも、部分対数尤度が受理の許容幅を超えて下がった場合です。受理の許容幅は、直前の反復での部分対数尤度の絶対値に 1 を足した値の 倍です。3 つ目は、情報行列を解けず更新の方向を求められなかった場合です。止まった時点で、観測範囲にわたる対数ハザード比の変化が 10 を超える係数があれば、警告はその共変量を示します。ほぼ共線な共変量や、各イベント時点でどの対象がイベントを起こすかをほぼ決める共変量がないか、共変量の数に対してイベント数が少なすぎないかを確認してください。止まった時点で分離、情報行列の特異、有限の正の値にならない分散のいずれかが判明した場合は、未収束の結果ではなく、そのエラーを表示します
- 分離(monotone likelihood): ある共変量がイベントの順序を強く分離して係数が発散すると、部分尤度に有限の最大値が存在せず推定値が定まりません。MIDAS は適合を中止し、該当する共変量を示すエラーを表示します。ある共変量(またはそのカテゴリ)が各イベント時点でどの対象がイベントを起こすかを完全に決めていないか、共変量の数に対してイベント数が少なすぎないかを確認してください。分離する共変量を除外・統合するか、共変量の数を減らして再適合してください
- 分離の兆候(警告): 適合が成功して係数と標準誤差が得られた場合でも、分離に近いデータでは推定を信頼できないことがあります。係数の推定値が極端で標準誤差がその推定値を覆うほど大きい場合、共変量の組み合わせ方向でだけ同じ状態が起きている場合、または部分尤度は収束したのに係数がまだ安定していない場合、MIDAS は結果とともに警告を表示します。警告が対象として示す項や共変量の組み合わせについて、標準誤差と信頼区間は信頼できません。係数が安定する前に収束した場合は、係数とハザード比の値自体も信頼できないことがあります。この検出は正当な強い効果への誤警告を避ける保守的な設定のため、警告が出ないことは分離の兆候がないことを意味しません。分離のエラーと同じ観点でデータを確認してください
- 非有限の分散: 共変量が極端な値域を持つと、分散の計算がオーバーフローまたは未定義になり、標準誤差を計算できずエラーになります。共変量をリスケールまたは標準化してから再適合してください
- 時間変数、イベント変数、共変量のいずれかに欠損値を含む行は自動的に除外されます(リストワイズ除去; 妥当な推定の条件は 欠損データのメカニズム を参照)。除外が発生した場合は、除外された行数が結果に表示されます。時間変数・イベント変数の欠損で落ちた行数と、共変量の欠損で落ちた行数は分けて示されます
See also
- 生存分析の基礎 - 生存時間データ、Kaplan-Meier、Cox モデルの数理的背景
- Kaplan-Meier タブ - 生存曲線の推定と RMST による群間比較
- チュートリアル: Kaplan-Meier 分析 - サンプルデータを使った実践例
参考文献
- Grambsch, P. M. and Therneau, T. M. (1994). Proportional hazards tests and diagnostics based on weighted residuals. Biometrika, 81(3), 515--526. https://www.jstor.org/stable/2337123
このページの Markdown 版もあります。