ARIMA タブ
ARIMA タブは、1 つの数値列を時系列とみなして ARIMA モデルを当てはめます。ARIMA(p,d,q) は、系列を d 回差分したうえで各時点の値を表すモデルです。各時点の値は、直前 p 時点の値(自己回帰、AR)と直前 q 時点の誤差項(移動平均、MA)の線形結合で表されます。次数 p, d, q は手動で指定するか、自動選択に任せられます。季節周期を指定すると、季節次数を加えた ARIMA(p,d,q)(P,D,Q)[s] になります。このモデルは季節 ARIMA(SARIMA)と呼ばれます。自動次数選択の手続きと理論的背景は ARIMA の自動次数選択 で説明しています。
ARIMA タブは、データセットの行の並び順を観測の時間順として扱います。時間列の指定はなく、観測の間隔が等しいことを仮定します。行が時間順に並んでいない場合は、SQL Query Editor タブ などで並べ替えたデータセットを先に用意してください。
基本的な使い方
以下の例では Bike Sharing (Daily) データセットを使用しています。リンクを開くと、MIDAS がこのデータセットを読み込んだ状態で起動します。
ARIMA を開く
メニューバーから Analysis > ARIMA... を選択します。
分析の設定
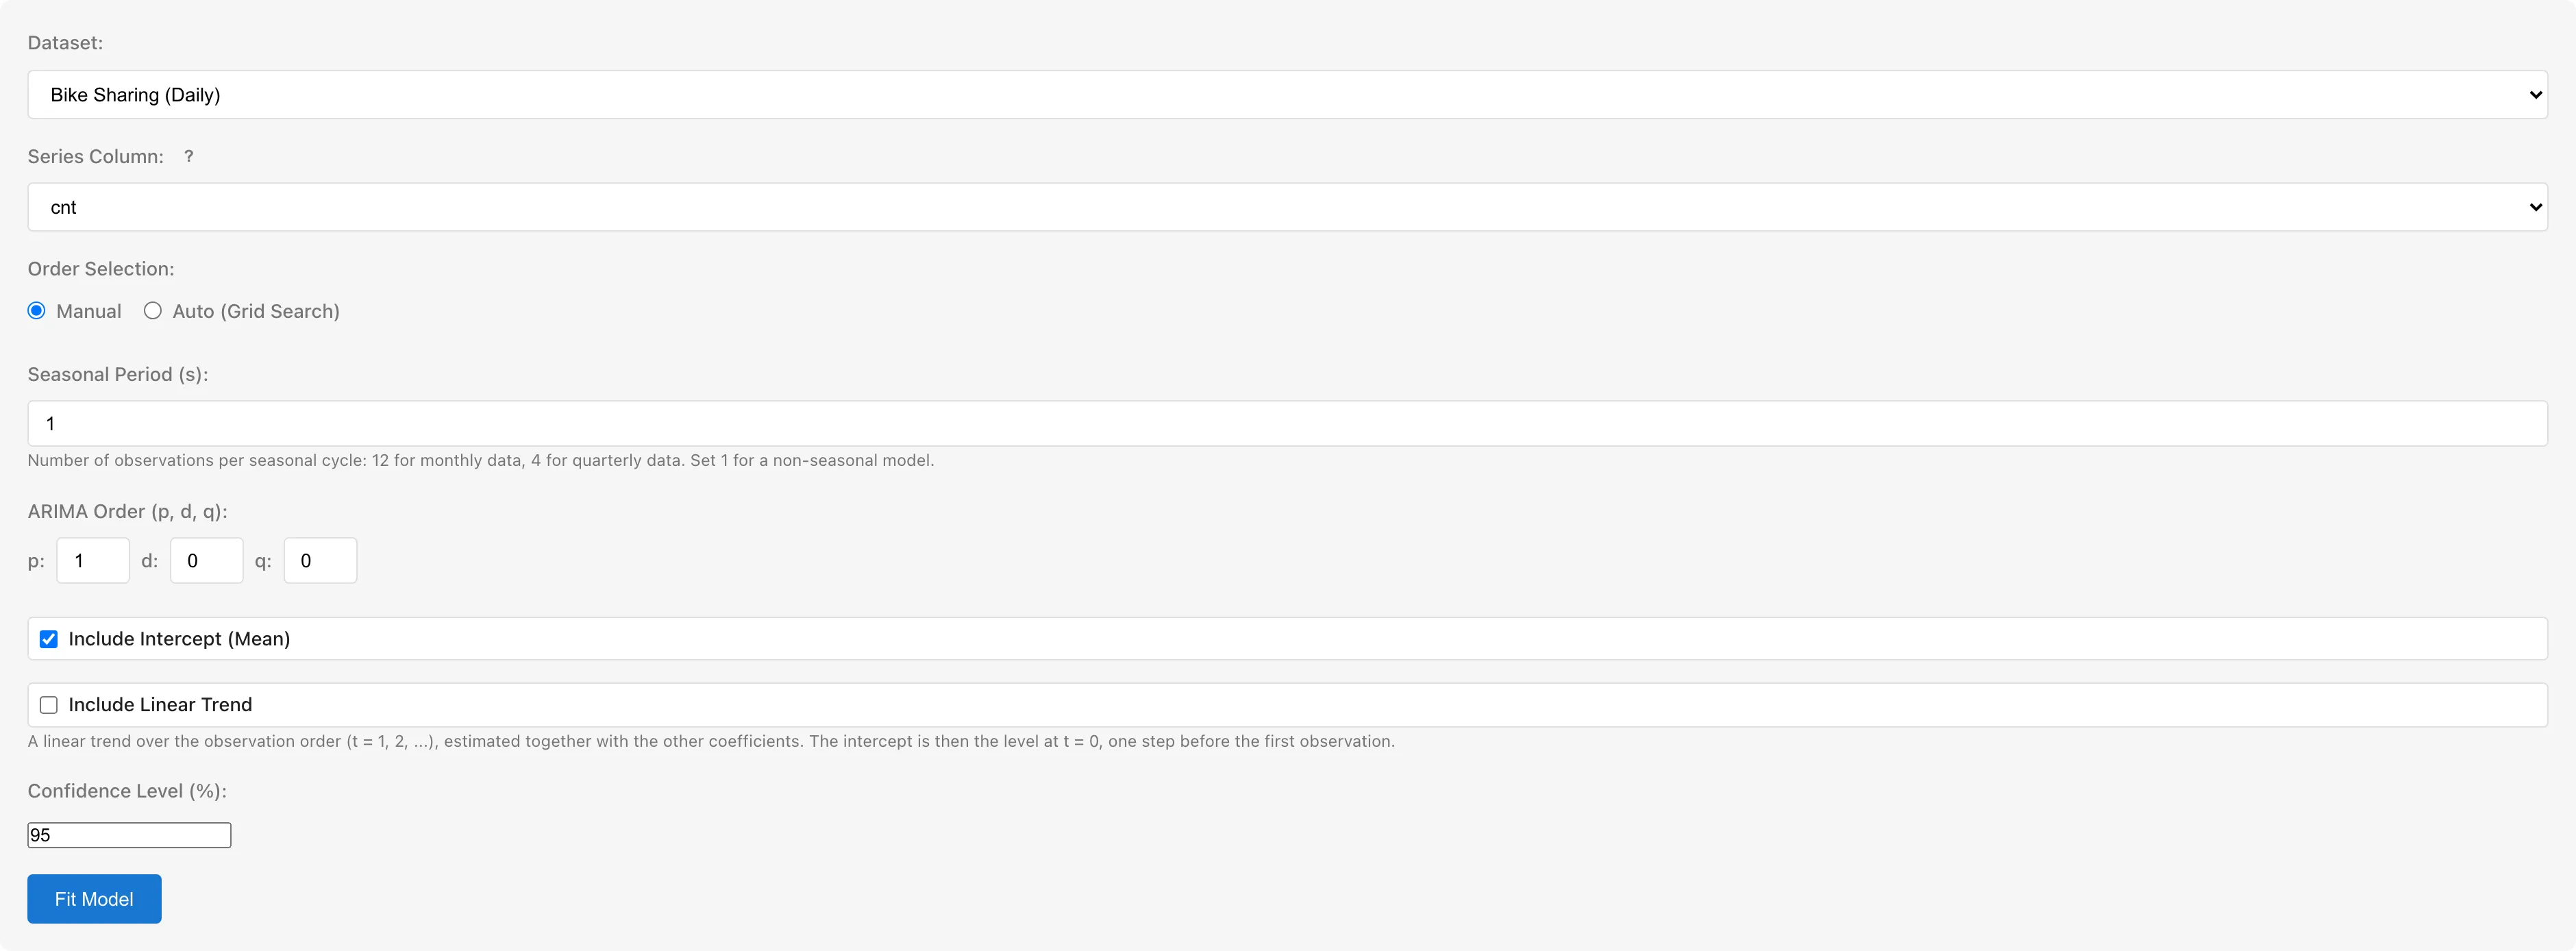
Dataset で分析対象のデータセットを選択します。
Series Column で系列にする列を選択します。数値型(間隔・比率尺度)の列のみ選択できます。
Order Selection で次数の決め方を選びます。Manual は次数を直接指定し、Auto (Grid Search) は次数を自動選択します。デフォルトは Manual です。
Seasonal Period (s) は 1 周期あたりの観測数です。月次データの年周期なら 12、四半期データなら 4 を指定します。1 を指定すると季節成分のないモデルになります。デフォルトは 1 です。1
次数の手動指定
ARIMA Order (p, d, q) で 3 つの次数を指定します。p は自己回帰項の数で 0〜5、d は差分次数で 0〜2、q は移動平均項の数で 0〜5 の範囲です。デフォルトは (1, 0, 0) です。
Seasonal Period が 2 以上のときは Seasonal Order (P, D, Q) も指定します。P は季節自己回帰項の数で 0〜2、D は季節差分次数で 0〜1、Q は季節移動平均項の数で 0〜2 の範囲です。デフォルトは (0, 0, 0) です。
次数の自動選択
Auto (Grid Search) は、差分次数を定常性の検定で先に決め、残りの次数はその差分次数のもとで候補の全組み合わせを当てはめて選びます。差分次数 d は KPSS 検定で決まります。季節モデルでは、季節差分次数 D が OCSB 検定でさらに先に決まります。p と q(季節モデルでは P と Q も)は、当てはめた候補のうち選択規準が最小のものが選ばれます。差分次数だけを AIC・BIC ではなく検定で決める理由は ARIMA の自動次数選択 を参照してください。
Search Range で p, d, q の探索上限を指定します。デフォルトは max p = 3、max d = 1、max q = 3 です。
Seasonal Period が 2 以上のときは Seasonal Search Range で季節次数 P, Q の探索上限を指定します。デフォルトはどちらも 1 です。季節差分次数 D は OCSB 検定で自動的に決まるため、入力欄はありません。
Selection Criterion で選択規準を AIC と BIC から選びます。デフォルトは AIC です。
定数項とトレンド項
定数項のチェックボックスは、差分の合計 d + D によって意味と表記が変わります。d + D = 0 では表記が Include Intercept (Mean) で、定数項は系列の平均を表します。d + D = 1 では表記が Include Drift で、定数項は差分後の系列の平均(ドリフト)を表します。通常差分(d = 1)では元の系列の 1 期あたりの平均変化にあたり、季節差分だけを取った場合(D = 1)は季節周期 s 期あたりの平均変化にあたります。d + D が 2 以上ではチェックボックスが無効になり、定数項は推定されません。このときの定数項は元の系列の次数 d + D の多項式トレンドに相当するためです。Auto では差分次数が実行時に決まるため、表記は Include Intercept or Drift です。デフォルトはオンです。
Include Linear Trend は、観測順 t = 1, 2, ... に対する線形トレンド項をモデルに加えます。傾きが独立のパラメータとして推定されるのは d + D = 0 のときだけです。d + D = 1 では線形トレンドがドリフト項に吸収されます。通常差分では傾きがそのままドリフトになり、季節差分だけを取った場合はドリフトが傾きの s 倍になります。d + D が 2 以上では線形トレンドは差分で消えます。このため Manual でこれらの次数を指定するとチェックボックスは無効になります。2 Auto でオンにすると、差分前の系列への KPSS 検定が、トレンド定常性を帰無仮説とする変種に切り替わります。この切り替えの意味は ARIMA の自動次数選択: 逐次手続きの正当性と閾値の役割 を参照してください。デフォルトはオフです。
Confidence Level (%) で係数の信頼区間の水準を設定します。デフォルトは 95 で、50〜99.99 の範囲で指定できます。設定した水準は係数テーブルの Lower N% / Upper N% 列に反映されます。
分析の実行
Fit Model をクリックすると推定が始まります。係数は最尤法で推定します。実行中はボタンの表示が Fitting... に変わり、Auto では当てはめた候補数の進捗が (現在/合計) の形式で表示されます。Cancel で推定を中止できます。
実行後に系列の列や次数、季節周期、定数項・トレンド項の設定を変えると、表示中の結果は現在の設定のものではなくなります。MIDAS はこの結果を画面から外し、再実行を促すメッセージを表示します。設定を元に戻すと結果は再び表示されます。Dataset を変えたときは列の選択も初期化されるため、結果は戻らずに破棄されます。Confidence Level の変更では結果を保持します。信頼水準は推定済みの係数から区間だけを計算し直す設定だからです。
実行後に推定に使ったデータセットの内容が変わったときも、表示中の結果は現在のデータのものではなくなります。Reload Dataset・セルの編集・派生元データセットの変更がこれにあたります。MIDAS はこの結果を画面から外し、データセットが変更されたことを示すメッセージを表示します。この場合は設定を戻して結果を再表示する操作がないため、結果を得るには再実行が必要です。
結果の見方
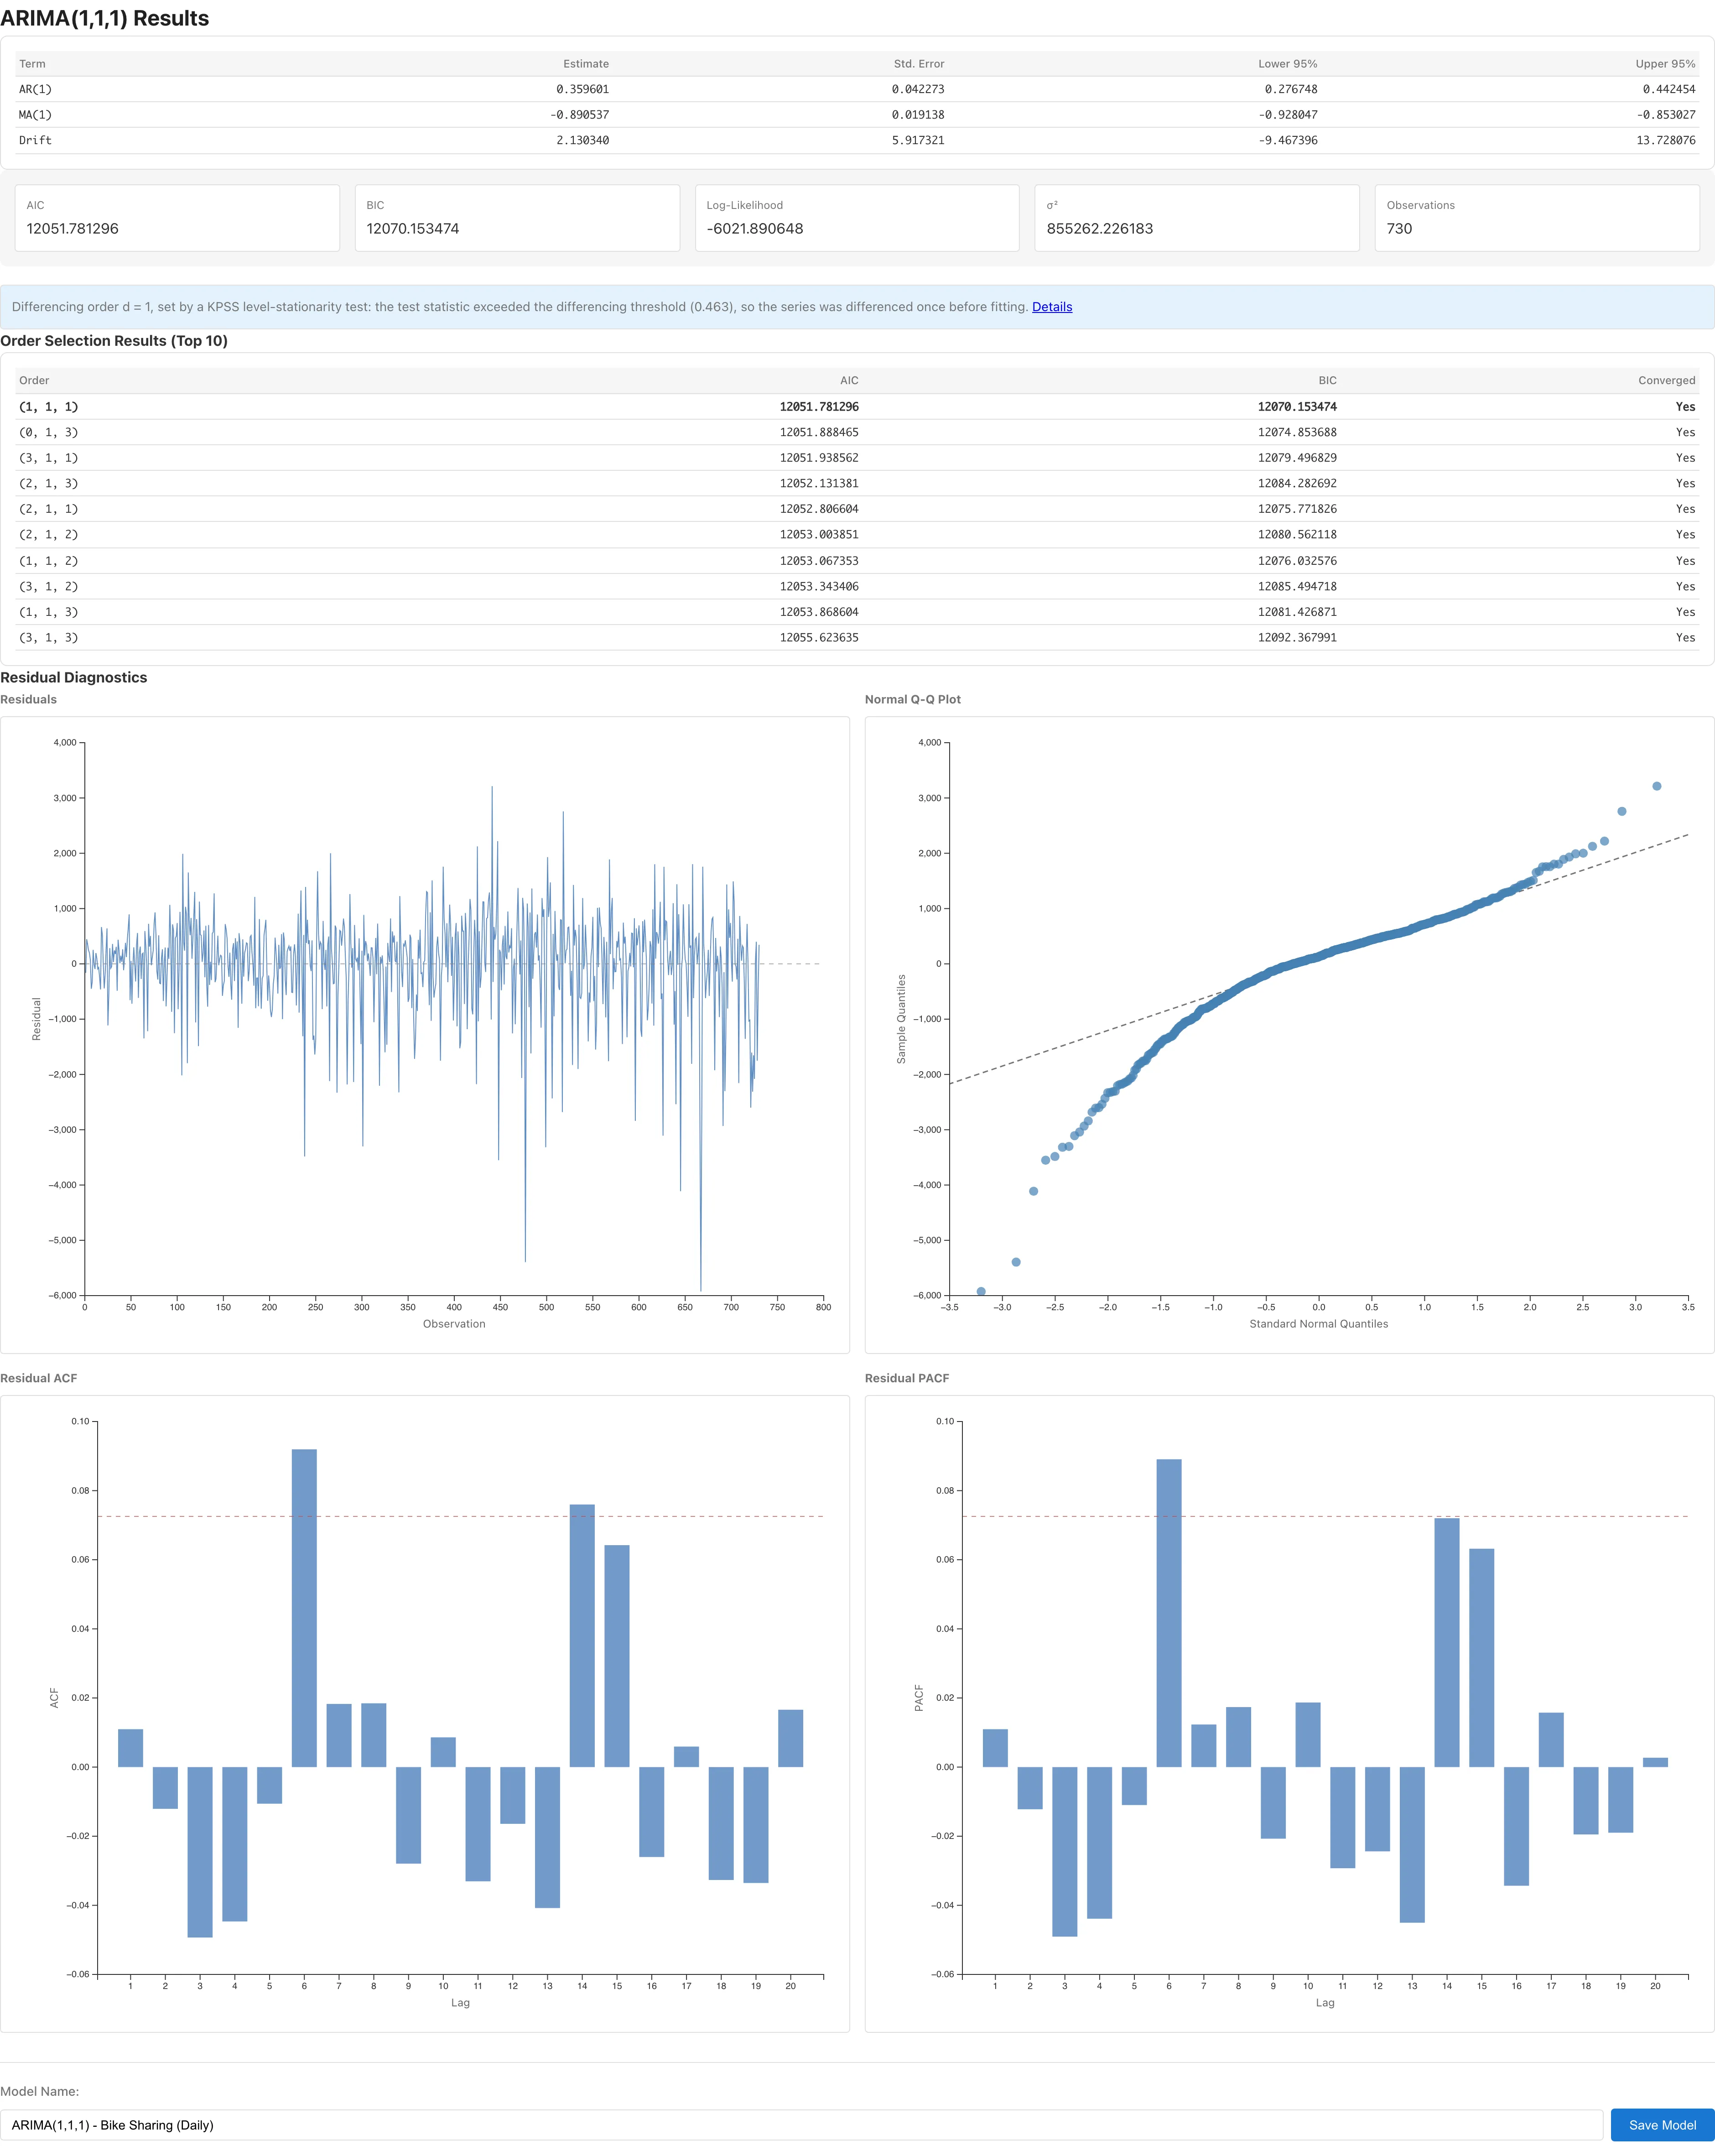
結果の見出しには、当てはめた次数が「ARIMA(1,0,0) Results」のように表示されます。季節モデルでは「ARIMA(1,0,0)(1,1,0)[12] Results」のように季節次数と周期を含みます。
Coefficients(係数テーブル)
係数テーブルには次の列が表示されます。
| 列 | 内容 |
|---|---|
| Term | 係数の項。AR(1), AR(2), ... は自己回帰係数、MA(1), ... は移動平均係数、SAR(1), ... と SMA(1), ... は季節自己回帰・季節移動平均係数です。定数項は d + D = 0 で Intercept、d + D = 1 で Drift と表示されます。線形トレンドの傾きは Trend です。 |
| Estimate | 係数の推定値 |
| Std. Error | 標準誤差 |
| Lower N% / Upper N% | 正規近似にもとづく信頼区間。N は設定した信頼水準です。 |
標準誤差を計算できなかった係数は、Std. Error と信頼区間の列が "-" になります。このとき、その旨の警告が結果の上部に表示されます。
適合度指標
係数テーブルの下に AIC、BIC、Log-Likelihood、σ²、Observations が並びます。σ² は誤差項の分散の推定値です。Observations は当てはめに使った差分後の系列の観測数です。欠損値・無効値の自動除外 の後に残った値の数より d + sD 少なくなります。推定が収束しなかった場合、尤度が最大化されておらず、そこから計算した値はそのモデルの AIC・BIC にならないため、AIC と BIC は「-」と表示されます。
AIC・BIC の比較が意味を持つのは、差分次数 d と D が同じモデルの間だけです。差分次数が異なると尤度を計算する対象のデータ自体が変わるため、AIC・BIC の大小はモデルの優劣を表しません。理由は ARIMA の自動次数選択: なぜ d だけ検定で選ぶのか を参照してください。
次数の決定根拠の注記
Auto では、差分次数をどう決めたかの注記が結果に表示されます。注記には、選ばれた差分次数と、KPSS 検定(季節モデルでは OCSB 検定も)の統計量が差分の判定閾値を超えたかどうかが書かれます。MIDAS はこの事実だけを示し、p 値や有意・非有意の判定は表示しません。
統計量が計算できない場合(系列が定数である、季節周期に対して系列が短いなど)は、注記にその旨が書かれ、その差分を行わずにモデル化されます。
定数項やトレンド項を要求したのに推定しなかった場合は、その理由の注記も表示されます。
探索した候補の一覧
Auto で複数の候補を当てはめた場合、選択規準で比較した候補と、比較から除外した候補が別々の一覧に表示されます。Order Selection Results (Top 10) は、推定が収束した候補を選択規準の小さい順に並べ、上位 10 候補を表示します。列は Order、AIC、BIC、Status で、選ばれたモデルの行は太字です。この一覧の Status はすべて Converged です。
Candidates Excluded from Selection は、選択から除外した候補を件数によらずすべて表示します。列は Order と Status で、Status は Not converged か Failed のどちらかです。推定が収束しなかった候補(Not converged)は、尤度が最大化されておらず、そこから計算した値がそのモデルの AIC・BIC にならないため、選択から除外されます。この一覧の候補は AIC・BIC を持たないため、一覧に AIC・BIC の列はありません。選択から除外した候補が 1 件もなければ、この一覧は表示されません。
適合そのものが成立しなかった候補(Failed)は、非収束とは別の理由で選択から除外されます。非収束は、反復が収束の基準を満たさないまま止まった状態で、次数や差分次数を変えれば収束することがあります。Failed は、差分後の観測数が次数に対して不足している、差分後の系列の分散がゼロである、尤度を評価できないといった理由で、その次数のモデルをこのデータでは組み立てられなかった状態です。Status 列にはその理由が添えられます。
非収束または Failed の候補が 1 件以上あるとき、2 つの一覧の直前に候補数と、非収束数と Failed の数を分けて述べる注記が表示されます。探索したすべての候補が非収束または Failed だった場合は、比較した候補がないため Order Selection Results (Top 10) は表示されません。このとき注記には、表示中のモデルが選択規準による比較の結果ではなく、MIDAS が比較できる候補がないときに当てはめる ARIMA(0,d,0) のフォールバックであることが明記されます。
残差診断
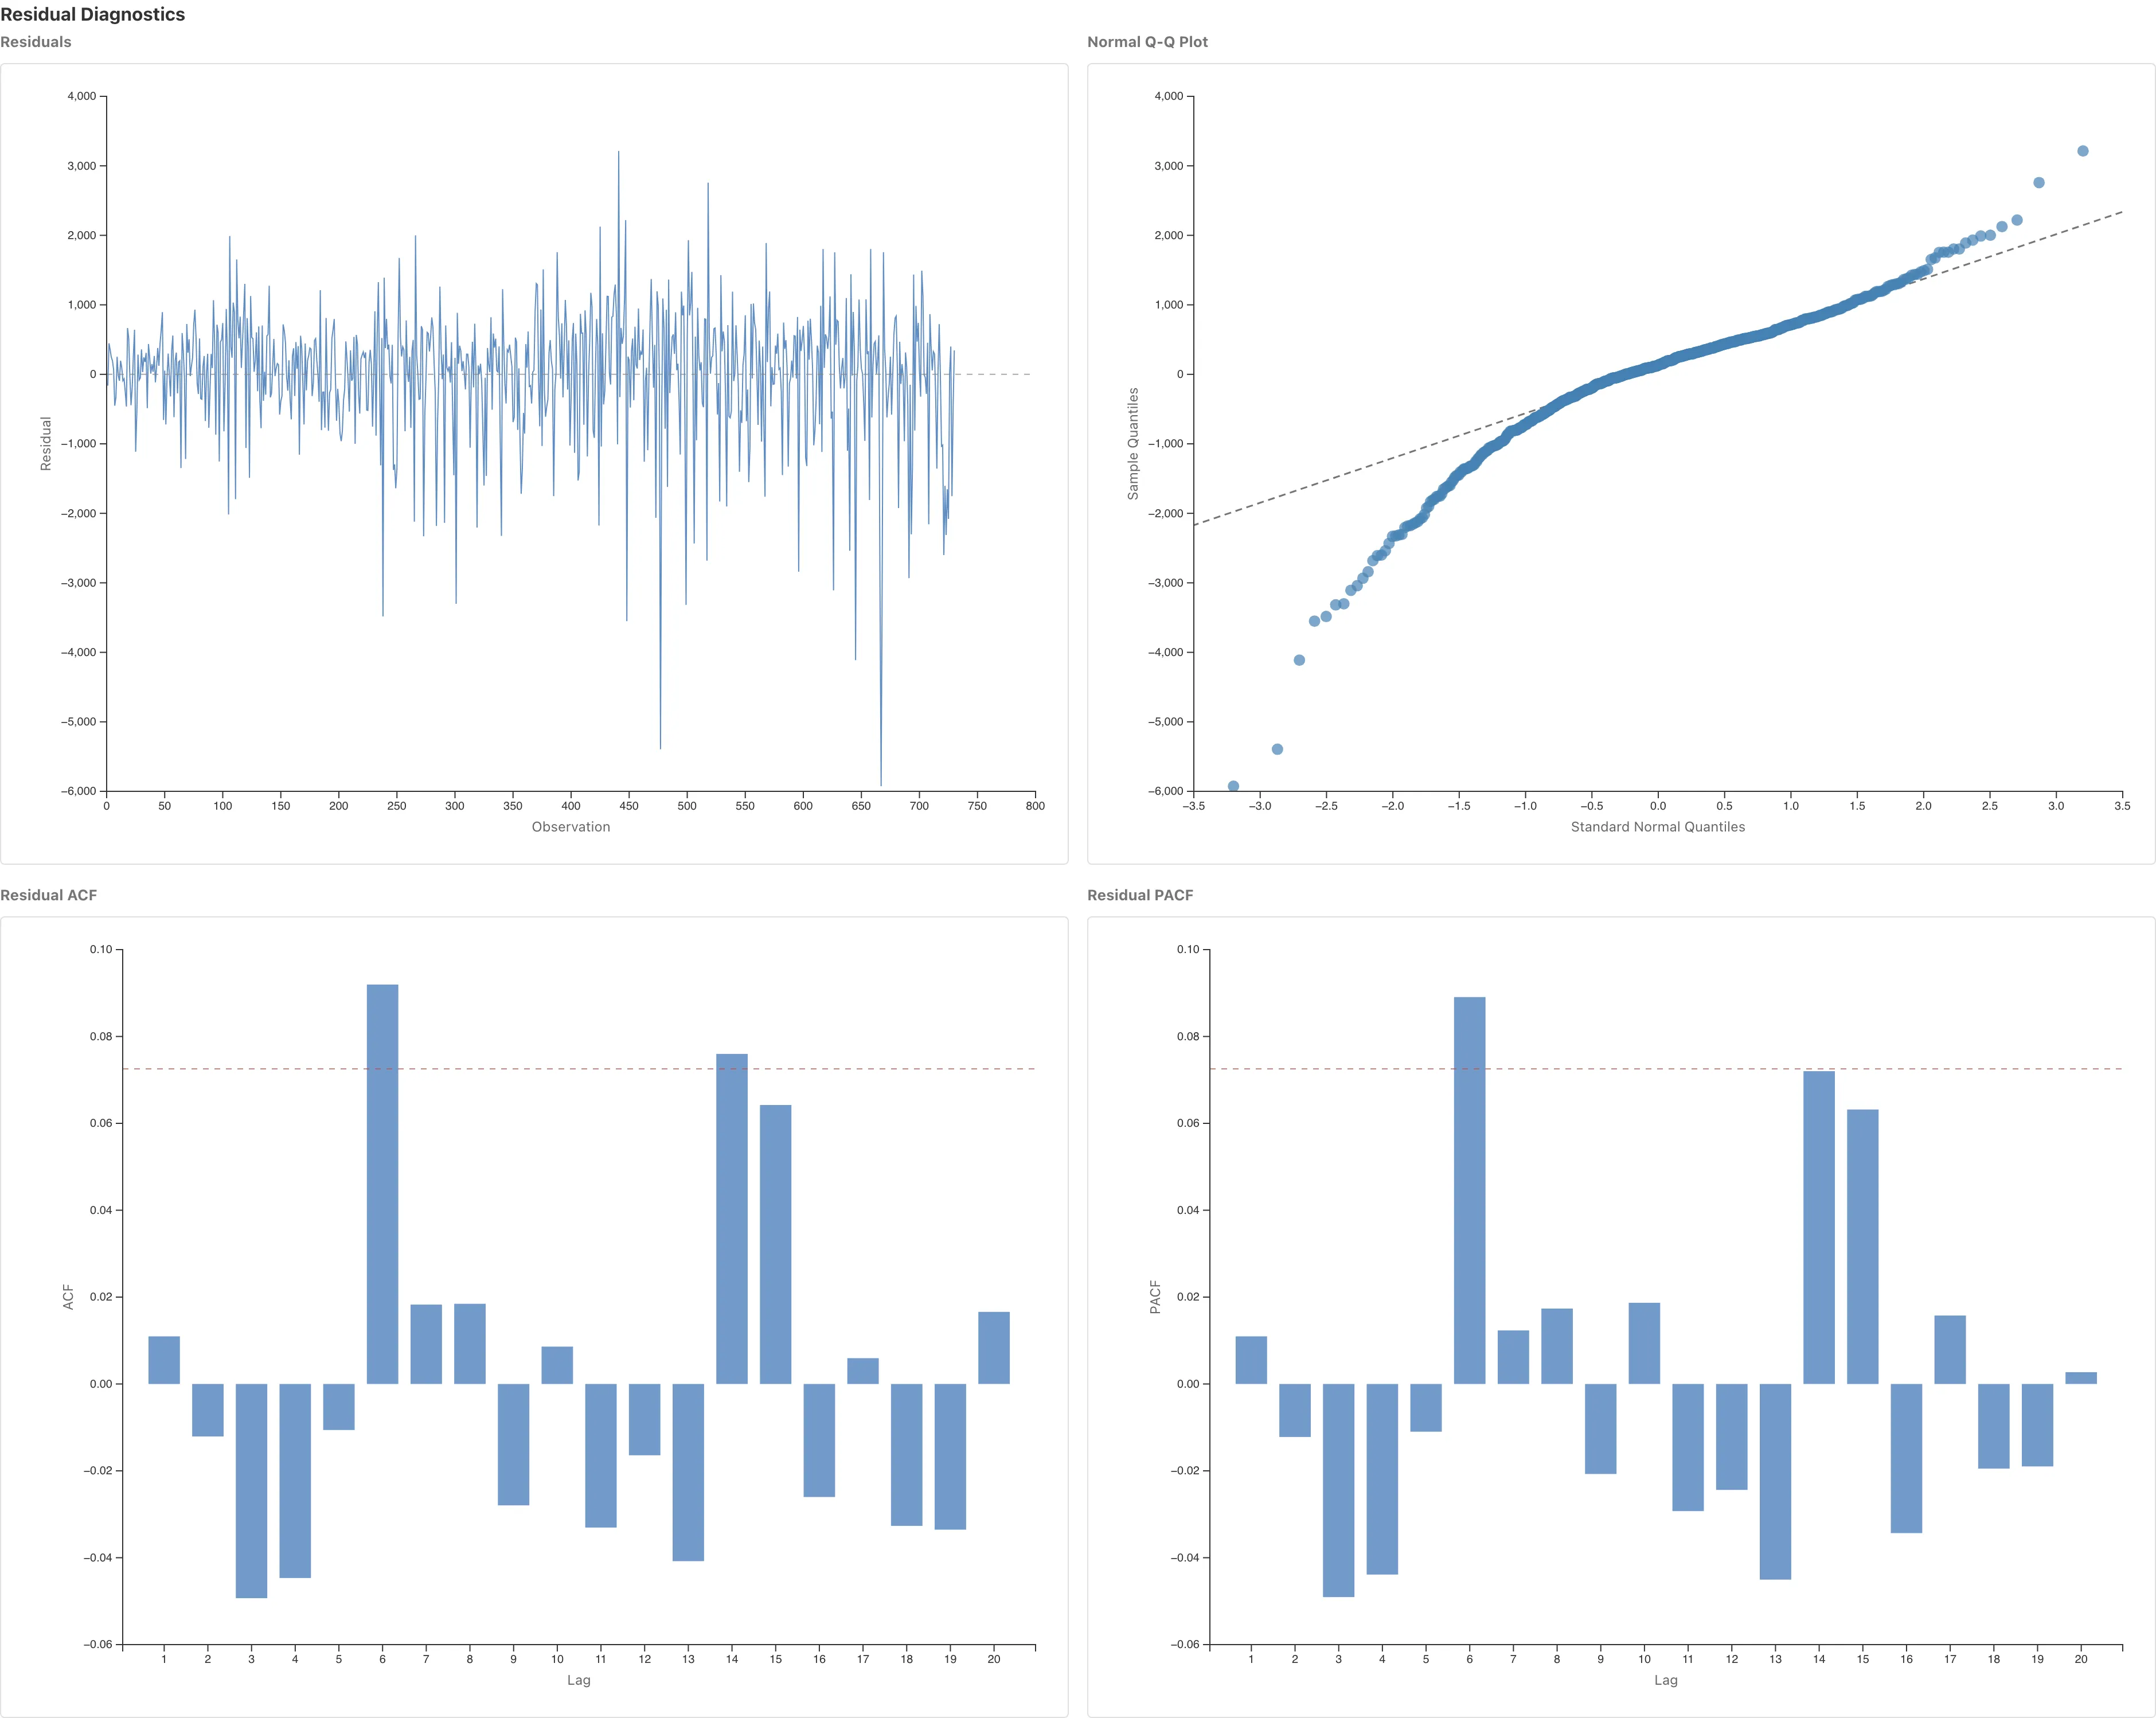
結果の下部に表示される Residual Diagnostics の 4 つのプロットで、モデルが系列の自己相関を説明しきれているかを確認できます。残差はモデルが説明できなかった変動で、モデルが系列の自己相関を捉えていれば無相関の系列に近づきます。
Residuals は残差を観測順にプロットします。破線は残差ゼロの水準です。モデルが適切であれば、残差はゼロの周囲に一定の幅で散らばります。時間とともに振れ幅が変わるパターンは、分散が一定という仮定がデータに合っていない可能性を示します。
Normal Q-Q Plot は残差の分位点を理論正規分位点に対してプロットします。点が直線に沿っていれば、残差の分布は正規分布に近いと判断できます。係数の信頼区間は正規近似にもとづくため、直線からの大きな逸脱があるときは信頼区間を慎重に扱ってください。
Residual ACF と Residual PACF は、残差の自己相関関数と偏自己相関関数をラグ 20 まで表示します。破線の帯は ±1.96/√n(n は観測数)で、無相関の系列の標本自己相関が漸近的におよそ 95% の確率で収まる範囲の目安です。多くのラグで自己相関が帯の外に出る場合は、モデルが系列の自己相関を説明しきれておらず、次数を増やすか季節周期を見直す余地があります。帯は目安であり、無相関の系列でも 20 のラグのうち 1 つ程度は帯の外に出ます。また、この帯は観測系列そのものが無相関である場合の分散 1/n にもとづきます。当てはめたモデルの残差では、低次のラグの標本自己相関の分散が 1/n より小さくなるため、低次のラグでは帯が実際のばらつきより広く、残差に残る自己相関を見落とすことがあります。残差の分散がゼロで標本自己相関を定義できない場合は、プロットの代わりに計算できない旨の注記を表示します。
モデルの保存
Model Name にモデル名を入力し、Save Model をクリックします。モデル名は「ARIMA(1,0,0) - データセット名」の形式で自動生成されるため、そのまま使えます。
モデルを保存すると View Model Details と Save Coefficients as Dataset の 2 つのボタンが表示されます。
View Model Details は Model Detail タブを開きます。保存済みモデルの係数テーブル、適合度指標、残差の ACF・PACF を、再推定せずに確認できます。
Save Coefficients as Dataset は係数テーブルをデータセットとして保存します。保存されるデータセットの列は Term、Estimate、Std. Error、Lower N%、Upper N% です。保存したデータセットは CSV にエクスポートできます。
注意事項
欠損値・無効値の自動除外
欠損値(null)、非数値、無限大は系列から自動的に除外されます。時系列では、この除外の影響は他のタブのリストワイズ除去と性質が異なります。除外後に残った観測が連続した系列として扱われるため、系列の途中に欠損があると、実際には離れた時点の観測が隣接しているものとして扱われます。詳細は 欠損データのメカニズム を参照してください。
値を除外したときは、除外した数と時点の間隔が保たれるかどうかを、結果の上部の警告が示します。除外した値がすべて系列の先頭か末尾にあれば、残りの値が元の時点の間隔を保つことを警告が述べます。系列の途中で除外した値があれば、警告はその数を示し、除外した値をまたぐラグが元の時点の間隔と対応しないことを述べます。モデルが季節項を持ち、除外した値より後の値の季節周期の中での位置がずれる場合は、そのことも述べます。それまでに除外した値の数が季節周期 s の倍数であれば、位置はずれません。保存したモデルの Model Detail タブにも同じ警告が表示されます。
除外後の有効な観測数が 10 未満の場合は「Only 8 valid numeric observation(s) remain after removing 3 missing or non-finite value(s). ARIMA requires at least 10.」のようなエラーになり、推定は実行されません。
推定の警告
推定が収束しなかった場合は「Model did not converge. Results may be unreliable.」という警告が表示されます3。このときの係数と標準誤差は信頼できません。次数を減らす、差分次数を変える、Auto に切り替えるなどの変更を検討してください。
推定された自己回帰成分の根が単位円の近くにある場合は、自己回帰成分が非定常に近いことと、境界の近くでは推定値と正規近似の信頼区間が信頼しにくくなることを述べる警告が表示されます。警告はそこまでで、モデルの変更を促す文は含みません。AR 係数が 1 のすぐ近くに推定されるのは差分の不足の典型的な兆候なので、差分次数 d を増やすことを検討してください。
推定された移動平均成分の根が単位円の近くにある場合も、同様の警告が表示されます。この状態が過剰な差分で生じたと考えられる場合は、差分次数を 1 減らす検討を促す文が警告に含まれます。差分の過不足がそれぞれ推定をどう不安定にするかは ARIMA の自動次数選択: 逐次手続きの正当性と閾値の役割 を参照してください。
報告された係数と大きく異なる係数の組がほぼ同等にデータへ適合する場合は、係数が弱くしか識別されないことを示す警告が表示されます。MIDAS は複数の出発点から尤度を最大化し、見つかった最良の適合を報告します。別の出発点からの最適化がほぼ同じ対数尤度で明確に異なる係数に到達した場合に、この警告が出ます。警告が出ないことは係数が十分に識別されていることを保証しません。検出は、有限個の出発点から到達できた別解に限られるためです。報告された係数と信頼区間はこの曖昧さを含んでいません。この状態は自己回帰因子と移動平均因子がほぼ相殺するときに典型的に生じます。相殺は季節・非季節のどちらの項でも起き、警告は係数の差が現れた側の次数を減らす検討を促します。
関連ページ
- ARIMA の自動次数選択 -- 差分次数を検定で決める理由と、KPSS 検定・OCSB 検定の背景を説明します
- Agent API (window.midas) --
models.run()から ARIMA を実行する方法を説明します - 欠損データのメカニズム -- 欠損の除外が推定に与える影響を説明します
脚注
-
季節周期が大きいほど推定に時間がかかります。周期が 52 以上では 1 回の当てはめに数秒から数分かかることがあり、Auto では候補ごとにこの当てはめを繰り返します。フォームにその旨の注意が表示され、実行中の当てはめは Cancel で中止できます。 ↩
-
トレンド項をオンにすると、Intercept は系列の平均ではなく t = 0(最初の観測の 1 期前)における水準を表します。フォームの定数項の表記も Include Intercept (Mean) から Include Intercept に変わります。定数項をオフにしてトレンド項だけをオンにすると、平均関数は t = 0 で 0 に拘束されます。このとき傾きは時間あたりの変化に加えて系列の水準も担うため、水準が 0 から離れた系列では、傾きの推定値を変化率として読めません。 ↩
-
収束は、反復が収束の基準を満たして止まったことを指します。基準は、対数尤度の勾配が十分に小さいことか、探索した方向で対数尤度をそれ以上大きくできないことです。止まった点が定常・可逆域の境界上(偏自己相関の絶対値が 0.999 以上)にあるときは、境界上の偏自己相関を 1 つずつ 0.001 だけ内側へ動かした点でも対数尤度を評価し、そこで対数尤度が大きくなるなら基準を満たしたとはしません。収束した点は反復がたどり着いた局所的な解で、対数尤度が全体で最大であることは保証されません。 ↩
このページの Markdown 版もあります。