Sampling タブ
Sampling タブは、データセットから行を無作為に抽出し、結果を Derived Dataset として保存します。このページでは、行を抽出する元のデータセットを 入力データセット と呼びます。
次の表は、2 つの地域にある 5 つの店舗の、2 か月の売上です。このページでは、この表を例に使います。
| region | store | month | sales |
|---|---|---|---|
| East | E1 | 1 | 120 |
| East | E1 | 2 | 135 |
| East | E2 | 1 | 80 |
| East | E2 | 2 | 95 |
| East | E3 | 1 | 150 |
| East | E3 | 2 | 140 |
| West | W1 | 1 | 60 |
| West | W1 | 2 | 75 |
| West | W2 | 1 | 110 |
| West | W2 | 2 | 100 |
操作の流れ
Sampling タブでの抽出は、次の手順で進めます。
- Data > Sampling... で Sampling タブを開きます
- Dataset で入力データセットを選びます
- Method で With replacement か Without replacement を選びます
- 入力データセットを 層 に分けて抽出するときは Stratum column を、複数の行をまとめて抽出するときは Sampling unit column を選びます
- Sample size per stratum で、層ごとに抽出する数の決め方を選びます
- Replicates に抽出を繰り返す回数を、Seed に 乱数の系列を決める整数 を入力します
- Preview を押し、結果の行数・列数と先頭 100 行を確かめます
- Save as Dataset を押し、名前を付けて保存します
層と抽出単位
Sampling タブは、入力データセットを層に分け、層ごとに抽出します。層は、Stratum column の値が同じ行の集まりです。Stratum column が None のときは、入力データセットの全体が 1 つの層になります。Stratum column の値が欠損値の行は、まとまって 1 つの層になります。例の表で Stratum column に region を選ぶと、East の 6 行と West の 4 行がそれぞれ層になります。
Sampling タブは、1 回の抽出で、層から抽出単位を 1 つ選びます。Sampling unit column が None (each row is a unit) のときは、1 行が 1 つの抽出単位です。Sampling unit column に列を選ぶと、同じ層の中でその列の値が同じ行のすべてが 1 つの抽出単位になります。Sampling タブは、1 回の抽出でそれらの行をまとめて選びます。例の表で Sampling unit column に store を選ぶと、Sampling タブは 1 回の抽出で、1 つの店舗の 2 か月分の 2 行を選びます。
次の表は、Stratum column に region を、Sampling unit column に store を選び、各層から抽出単位を 1 つずつ抽出した結果の例です。Sampling タブは East から店舗 E1 を、West から店舗 W2 を選び、それぞれの 2 行を結果に入れています。先頭の 3 つの列は、結果の列 で説明します。
| Replicate | Draw | Source Row # | region | store | month | sales |
|---|---|---|---|---|---|---|
| 1 | 1 | 0 | East | E1 | 1 | 120 |
| 1 | 1 | 1 | East | E1 | 2 | 135 |
| 1 | 2 | 8 | West | W2 | 1 | 110 |
| 1 | 2 | 9 | West | W2 | 2 | 100 |
Sampling unit column の値が同じでも、層が違う行は別の抽出単位になります。たとえば例の表で Stratum column に month を、Sampling unit column に store を選ぶと、店舗 E1 の 1 月の行と 2 月の行は別の層に属するので、別の抽出単位になります。
Sampling unit column の値が欠損値の行が入力データセットにあると、Sampling タブは抽出できず、Preview はエラーを表示します。欠損値の行には属する抽出単位がなく、Sampling タブはその行を抽出の対象にできないためです。Sampling タブは、Stratum column の値が欠損値の行を 1 つの層にまとめますが、Sampling unit column の値が欠損値の行を 1 つの抽出単位にまとめません。
層ごとに抽出する数
Sample size per stratum は、各層から抽出する抽出単位の数を決めます。Sampling タブが数えるのは行ではなく抽出単位です。Sampling unit column に列を選ぶと、Sampling タブは抽出単位を 1 つ抽出するたびに、その抽出単位のすべての行を結果に入れます。選択肢は次の 4 つです。
- As many as the stratum has は、層にある抽出単位と同じ数を抽出します
- One fewer than the stratum has は、層にある抽出単位の数より 1 つ少ない数を抽出します
- Fixed number は、入力欄の数と同じ数を、どの層からも抽出します
- From a size table は、層ごとに抽出する数を別のデータセットから読みます
Sampling タブが、Sample size per stratum で決まる数の抽出単位を各層から抽出して得る行の集まりを、このページでは標本と呼びます。Replicates が 1 のとき、結果のデータセットは 1 つの標本です。Replicates が 2 以上のとき、Sampling タブは標本を Replicates の数だけ作り、結果のデータセットに縦に並べます。
Without replacement で各層から抽出できる数は、その層にある抽出単位の数までです。As many as the stratum has はこの上限と同じ数を抽出します。このとき Sampling タブは、各層のすべての抽出単位を 1 回ずつ、無作為な順で選びます。
層ごとに抽出する数は、標本で数値の列を層ごとに合計した値の期待値を決めます。抽出単位が 個ある層から 個を抽出すると、復元抽出でも非復元抽出でも、どの抽出単位も選ばれる回数の期待値が になります。このため、ある層から抽出された行で数値の列を合計した値の期待値は、その層のすべての行で合計した値の 倍です。 がすべての層で等しければ、各層の合計の期待値は、入力データセットでの各層の合計に比例します。Fixed number で抽出すると、抽出単位の数が違う層の間で が異なるので、各層の合計の期待値は入力データセットでの各層の合計に比例しません。
Size table
size table は、層ごとに抽出する数を並べたデータセットです。次の表は、例の表の East から 2 個、West から 1 個の抽出単位を抽出する size table です。region 列に層の値を、size 列にその層から抽出する数を入れています。
| region | size |
|---|---|
| East | 2 |
| West | 1 |
Sampling タブは、入力データセットの層ごとに、層の値が同じ行を size table から探し、その行にある数だけ抽出単位を抽出します。上の size table では、region が East の行の size が 2 なので、Sampling タブは East の層から抽出単位を 2 個抽出します。
size table には、入力データセットにある層のそれぞれについて、行を 1 つだけ入れます。Stratum column の値が欠損値の行をまとめた層から抽出する数は、層の値が欠損値の行に入れます。
抽出する数の列には数値型の列を選び、その列には 0 以上の整数を入れます。Sampling タブは、0 を入れた層から何も抽出しません。
層の値の列には、Stratum column と値を比べられるデータ型の列を選びます。string 型と enum 型の列は互いに比べられ、int64 型と float64 型の列も互いに比べられます。date 型、datetime 型、boolean 型の列は、同じデータ型の列とだけ比べられます。
抽出の繰り返し
Sampling タブは、標本を作る処理を Replicates に入力した回数だけ繰り返し、得られた標本を縦に並べて 1 つのデータセットにします。Sampling タブは標本を 1 つずつ別に作るので、Without replacement で抽出しても、同じ行が 2 つ以上の標本に現れることがあります。Sampling タブが作れる結果は、10,000,000 行までです。
Seed
Seed は、抽出に使う乱数の系列を決める整数です。同じバージョンの MIDAS では、同じデータに同じ設定と同じ Seed を与えると、同じ標本が得られます。MIDAS を更新した後は、同じ Seed でも標本が変わることがあります。Replicates が 2 以上のときも Seed は 1 つで、すべての標本がこの Seed から決まります。
結果の列
結果のデータセットは、入力データセットの列の前に Replicate・Draw・Source Row # の 3 つの列を持ち、行はこの 3 つの列の値の順に並びます。3 つの列の値は次のとおりです。
Replicateは、1 から始まる標本の番号ですDrawは、標本の中で 1 から始まる抽出の順番ですSource Row #は、抽出された行の、入力データセットでの 行番号 です
次の画面は、例の表から With replacement で抽出した結果です。Stratum column には region を、Sampling unit column には store を選び、Sample size per stratum は As many as the stratum has に、Replicates は 2 にしました。Sampling タブは、1 つの標本で East から 3 回、West から 2 回、店舗を選びます。1 回に選ぶのは 2 行なので、結果は 2 つの標本を合わせて 20 行になります。
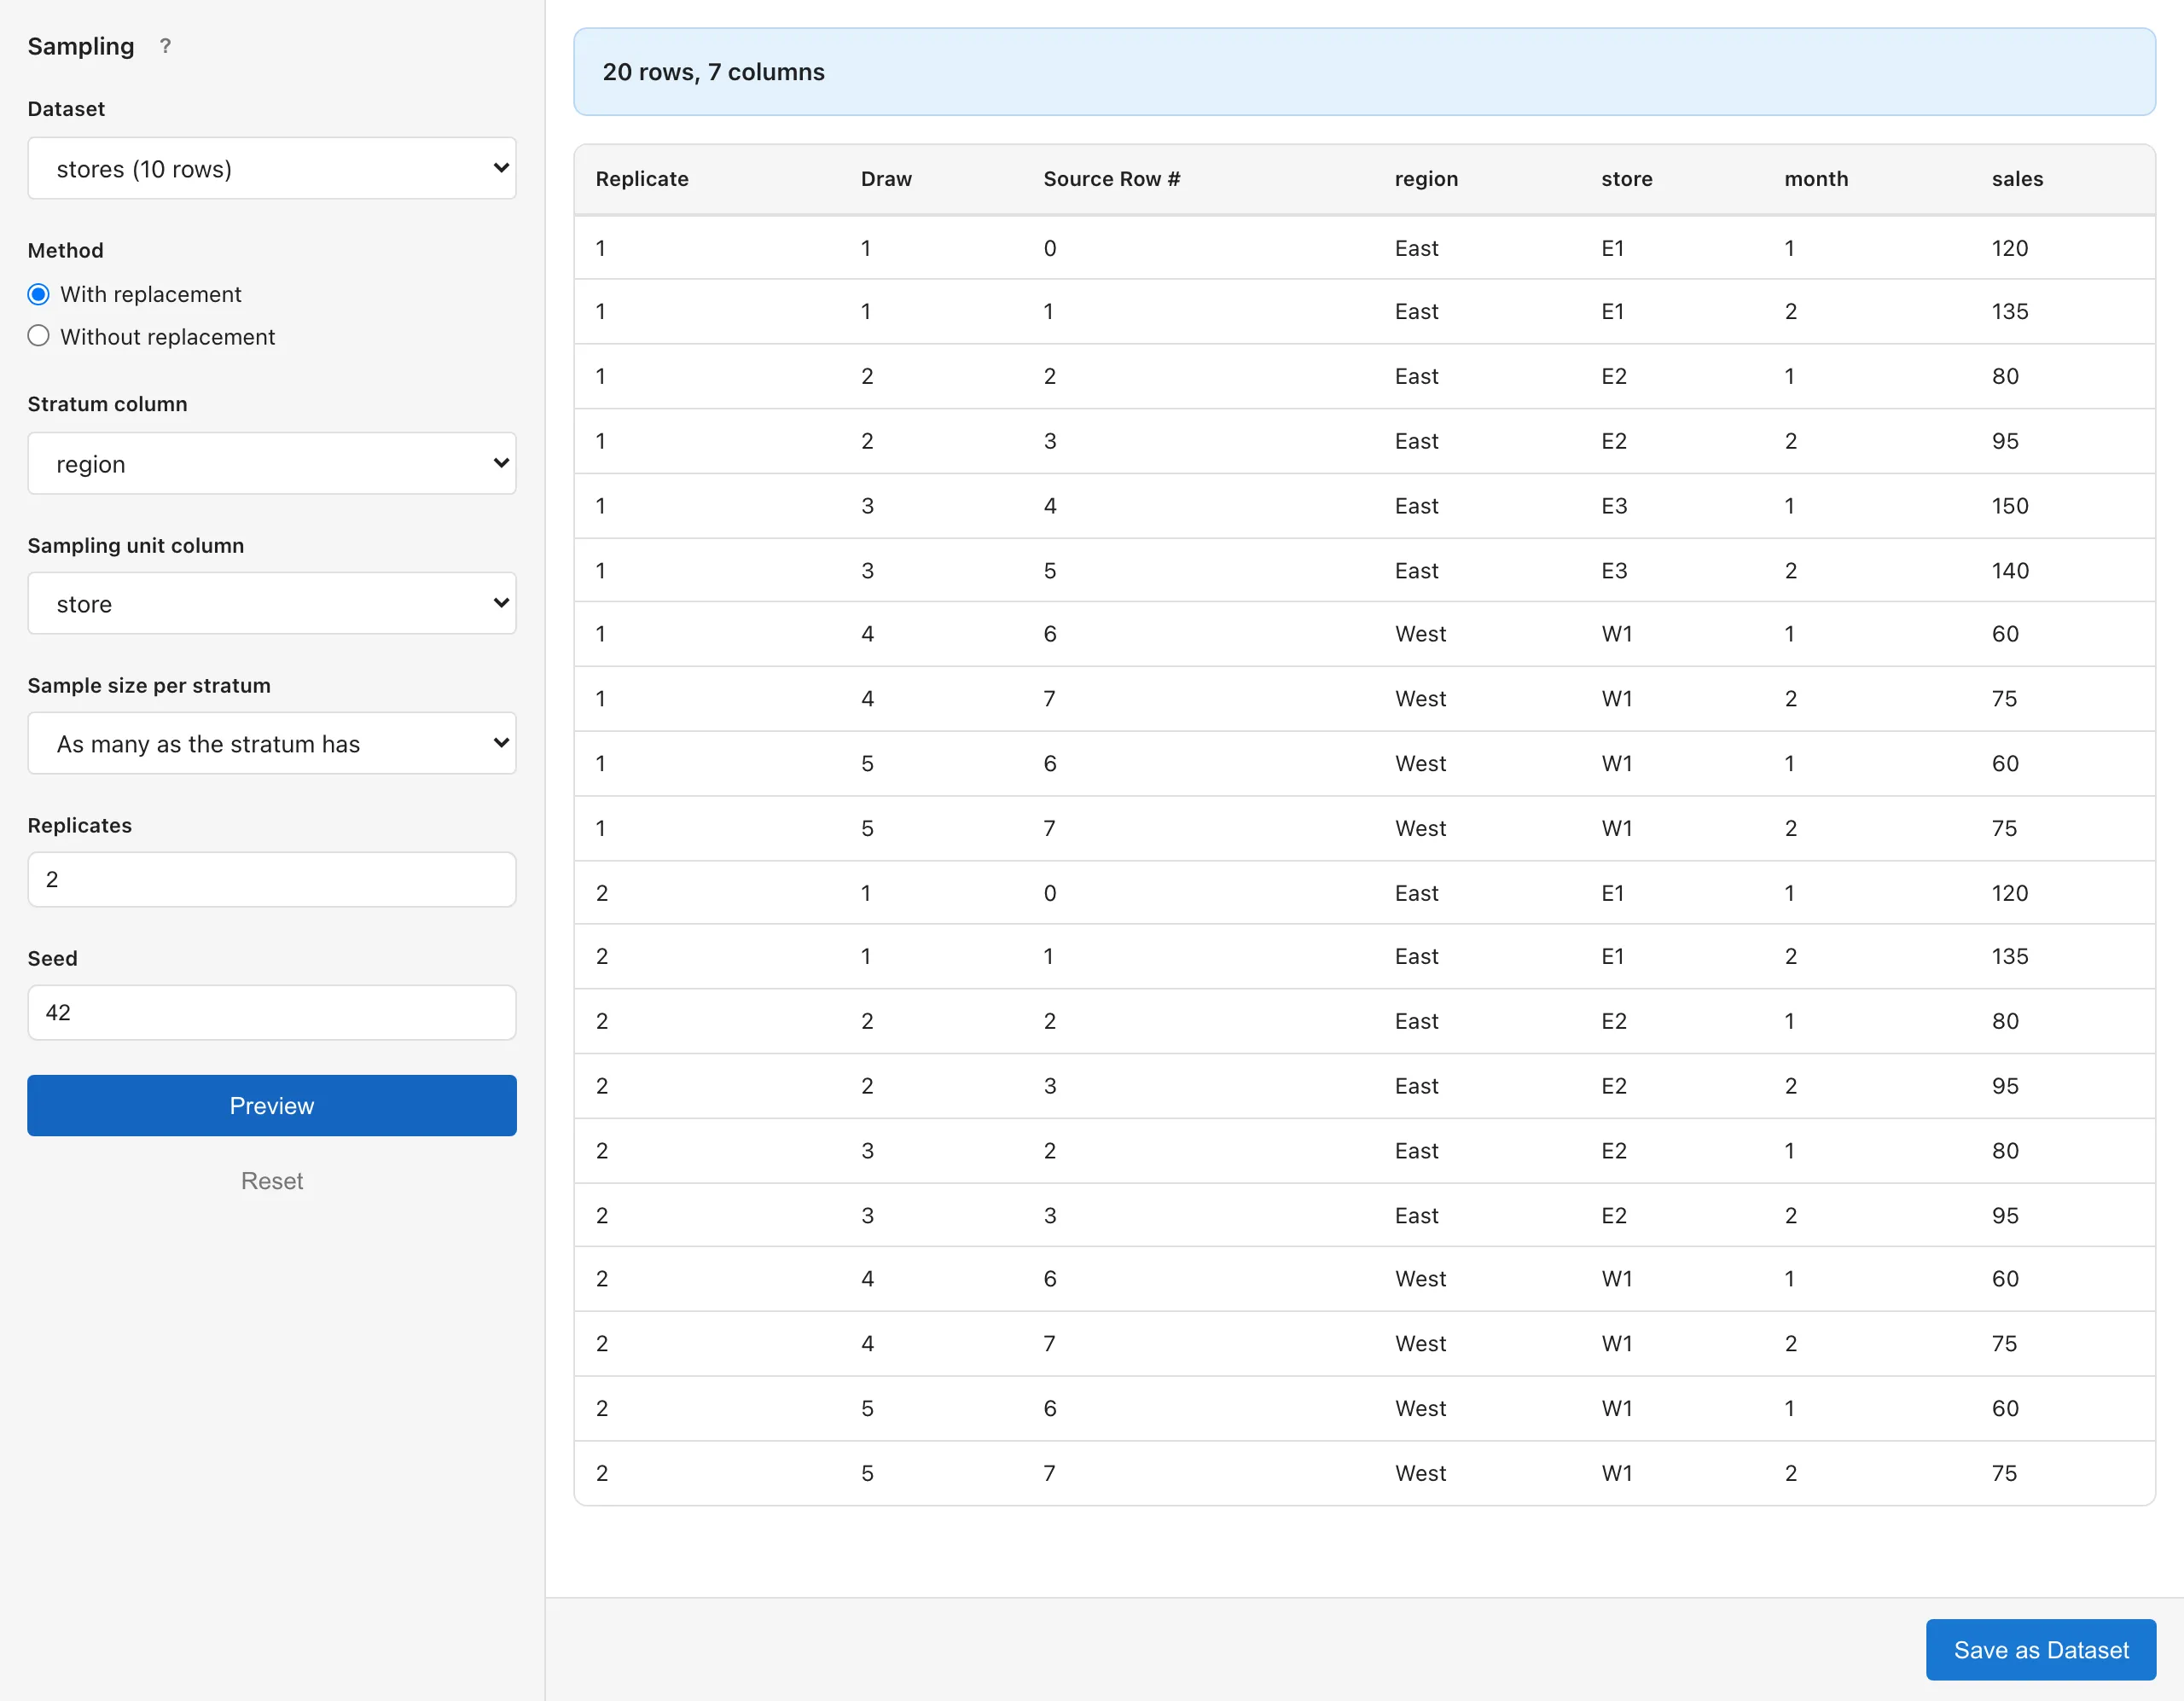
Draw の番号は、1 つの標本の中で層をまたいで続きます。画面の例では、Draw の 1 から 3 が East からの抽出で、4 と 5 が West からの抽出です。1 回の抽出で選ばれた行は、同じ Draw の値を持ちます。
復元抽出で同じ抽出単位が 2 回以上選ばれたときは、Replicate と Draw の組で各回を区別します。1 つの標本で 2 回選ばれた抽出単位の行は、結果に 2 回現れます。この 2 回分の行は、Sampling unit column の値も Source Row # の値も同じで、Draw の値だけが違います。画面の例では、1 つ目の標本で店舗 W1 が 2 回選ばれ、W1 の 2 行が Draw の 4 と 5 に 1 回ずつ現れています。
保存したデータセット
入力データセットか size table を変えると、MIDAS は Save as Dataset で保存した Derived Dataset の行を、同じ設定と Seed で抽出し直します。依存関係と再計算は、データセットと依存関係 で説明しています。
保存した Derived Dataset の抽出の設定を変えるには、Project Lineage タブ でデータセットを右クリックし、Edit Operation... で Sampling タブを開きます。設定を変えた後、Update Dataset から更新します。
このページの Markdown 版もあります。